「ローカルLLMのモデルを探すと、Q4_K_MとかQ4_0とか、同じモデルなのにファイルがたくさんある。どれを選べばいいの?」
この記事は、LM Studioなどでローカルの文章AIを動かすときに、モデルのファイル名にある「Q4_K_M」などの意味と、選び方を知りたい人のための記事です。LM Studioの始め方はLM Studioの始め方にまとめています。
先に結論です。
- Q4_K_Mなどは、モデルを小さくする方式(量子化)の名前です。同じモデルでも、方式によってファイルの大きさが変わります
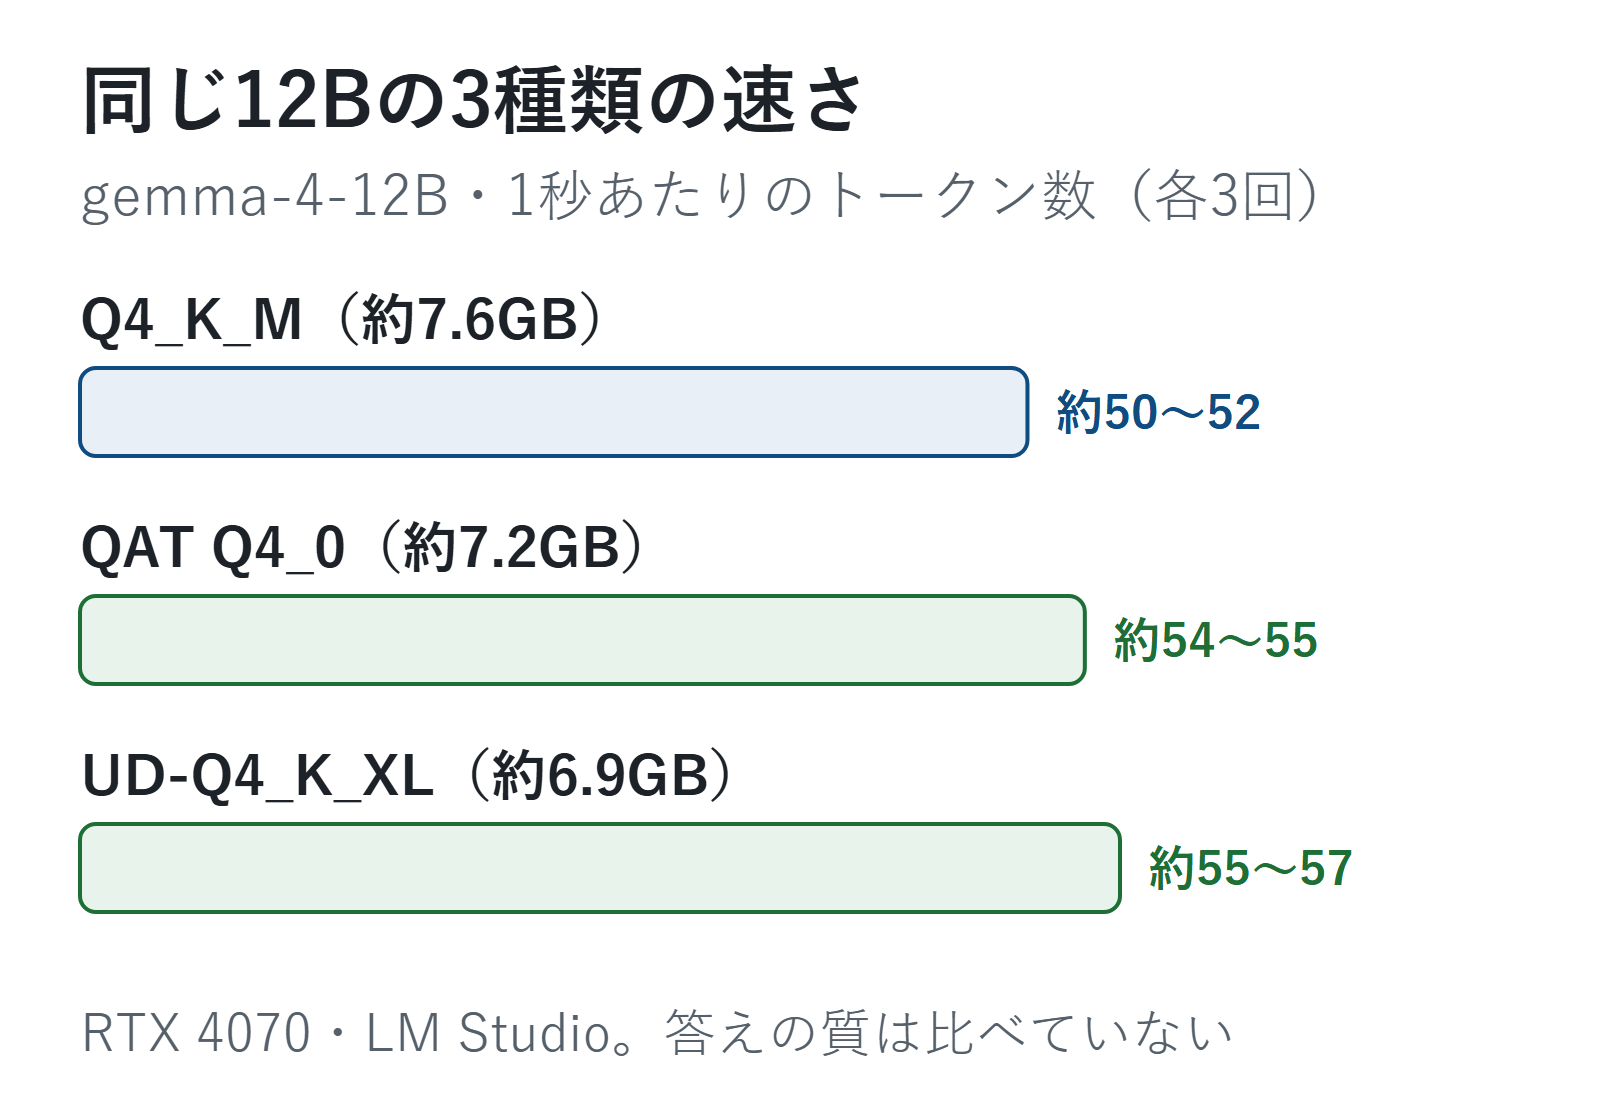
- 筆者のRTX 4070で、同じgemma-4-12Bの3種類のファイル(約6.9〜7.6GB)を比べると、小さいファイルほど少し速く、VRAMも少なめでした
- 差は大きくありません。速さは1秒あたり約50〜57トークンの範囲で、いちばん速いものといちばん遅いもので約1割でした
- 答えの質は比べていません。ファイルを選ぶときは、まずVRAMに収まる大きさかを見ます
2026年11月1日に、筆者のパソコンでLM Studioを使って測りました。
あなたならどれで十分か
| やりたいこと | 選び方 | 筆者の記録 |
|---|---|---|
| まずローカルLLMを動かしたい | VRAMに収まる大きさのファイルを1つ | 12Bの3種類は、どれも12GBのVRAMで動いた |
| 少しでも速くしたい | 同じモデルの、小さめのファイル | 約6.9GBのファイルが、約7.6GBより約1割速かった |
| 答えの質を重視したい | モデルの配布元の説明を読む | 筆者は質を比べていない |
| ファイル名の意味を知りたい | この記事の「なぜそう言えるか」 | 公式の説明で整理した |
差が出たのは、今回の12Bのモデル・筆者のパソコン・同じ頼み方での結果です。ほかのモデルや大きさで同じ差になるかは分かりません。
なぜそう言えるか:量子化はファイルを小さくする方式
ローカルLLMのモデルは、たくさんの数値でできています。量子化は、その数値を少ないビット数で表して、ファイルとメモリを小さくする方式です。GGUFは、こうしたモデルを読み込みやすく保存するファイルの形で、LM Studioなどで使えます(Hugging Faceの公式の説明)。
ファイル名の「Q4_K_M」「Q4_0」などは、量子化の方式の名前です。Hugging Faceの説明では、Q4_Kは1つの数値あたり約4.5ビット、Q4_0は昔からある方式で、今はあまり使われていないとされています。「QAT」は、Googleの説明によると、量子化を見込んで学習させる方法で、元の精度に近い質を保ちながら、メモリを大きく減らせるとされています。
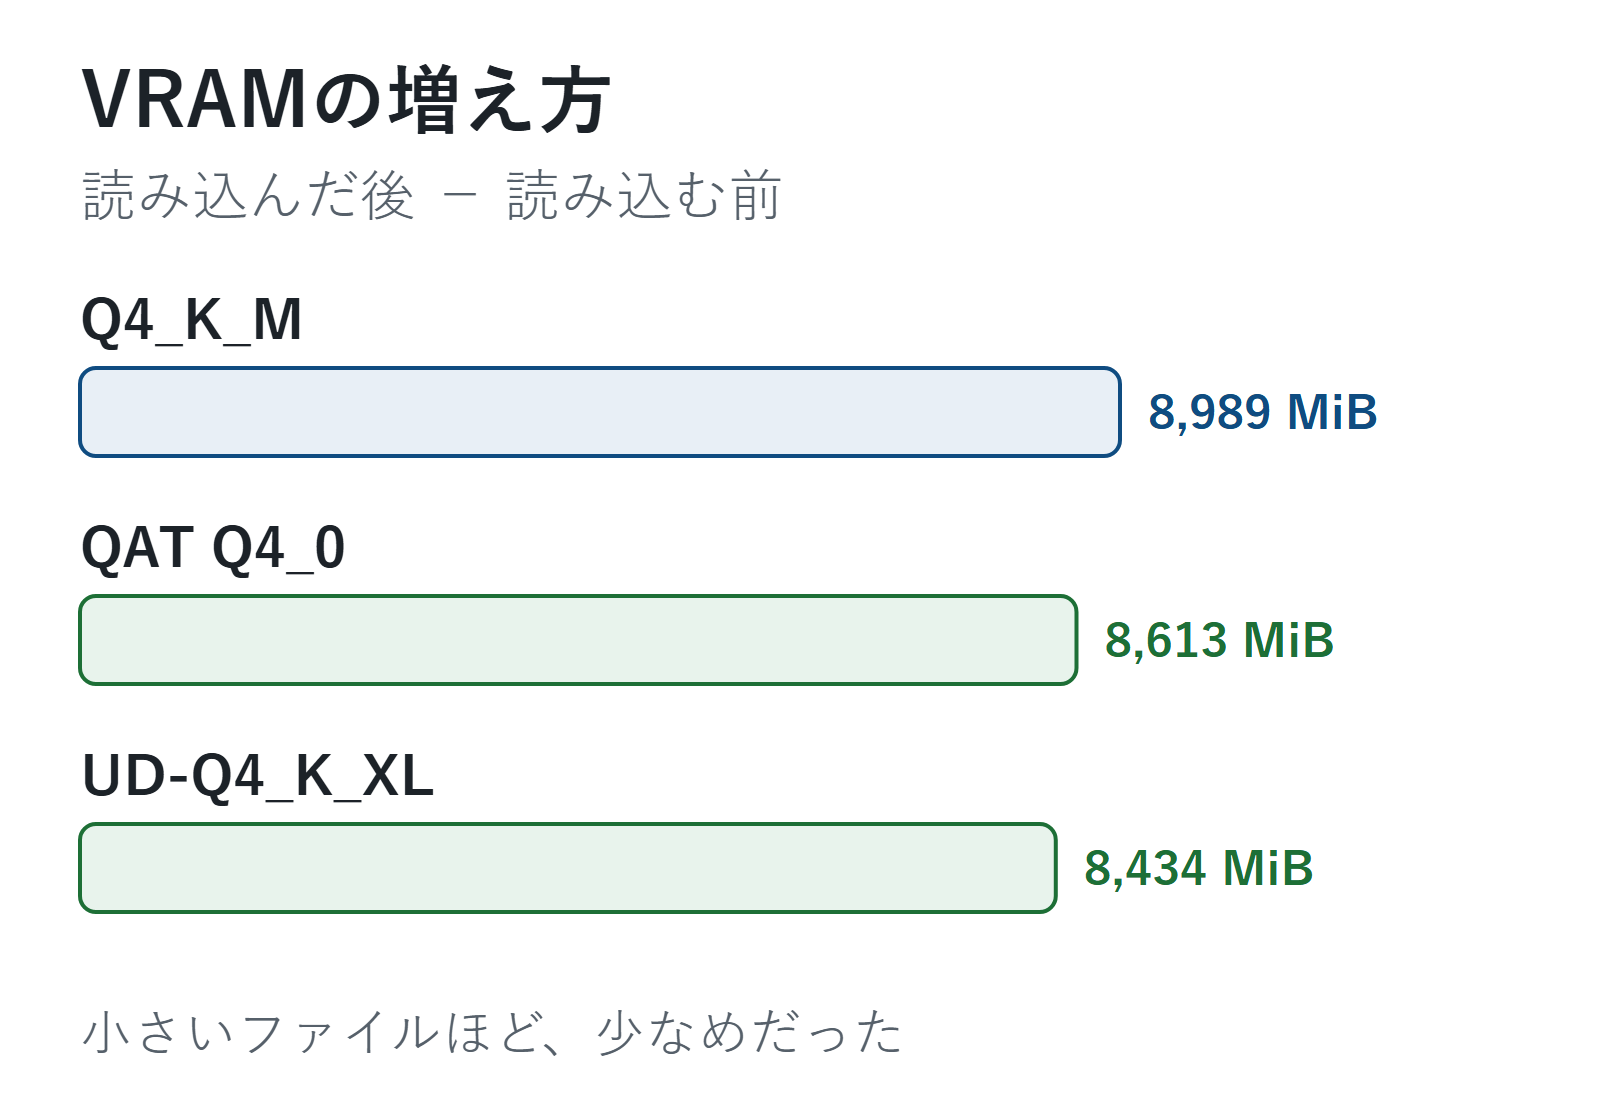
今回の3種類では、ファイルが小さいものほど、少し速く、VRAMの増え方も少なめでした。
実際に試した結果
| ファイル(大きさ) | VRAMの増え方 | 速さ(1秒あたり、3回) |
|---|---|---|
| Q4_K_M(約7.6GB) | 8,989 MiB | 51.9・52.0・49.8 |
| QAT Q4_0(約7.2GB) | 8,613 MiB | 54.1・55.1・53.8 |
| UD-Q4_K_XL(約6.9GB) | 8,434 MiB | 55.2・56.6・56.7 |
測った条件は、RTX 4070(12GB)でローカルLLMはどこまで動く?と同じです(RTX 4070・メモリ32GB、LM Studio、会話の長さの上限4096、同じ頼み方で各3回)。Q4_K_Mは、2つの記事の計測で読み込む前のVRAMが違い(1,482 MiBと635 MiB)、読み込んだ後のVRAM全体も10,493 MiBと9,624 MiBで違いました。ほかのアプリが使っている分で、全体の量が変わります。
ファイルを選ぶときに見る場所
- 今のVRAMの量:タスクマネージャーの「パフォーマンス」→「GPU」の「専用 GPU メモリ」で確かめます
- ファイルの大きさ:VRAMより十分小さいものを選びます。今回の12Bは、ファイル約6.9〜7.6GBで、VRAMが8,434〜8,989 MiB増えました
- 量子化の名前:同じモデルに複数あるときは、配布元の説明を読みます
- モデルのライセンス:配布元ごとに使い方の条件があります
よくある勘違い
- 数字が大きい方式ほど、必ずよい → 今回の3種類では、小さいファイルのほうが少し速く、VRAMも少なめでした。質は比べていません
- 量子化の違いで、速さが何倍も変わる → 今回の差は、約1割でした
- ファイルの大きさと、VRAMの使用量は同じ → ファイル約7.6GBのQ4_K_Mで、VRAMは8,989 MiB増えました
よくある質問
Q. 結局、どれを選べばいいですか?
A. まず、VRAMに余裕をもって収まる大きさのファイルを選びます。そのうえで、答えの質は自分の使い方で試して確かめます。筆者は今回、質を比べていないので、どれがよいとは書けません。
Q. もっと大きなモデルは動きますか?
A. 筆者のRTX 4070(12GB)では、ファイル約17.7GBの27Bは読み込めませんでした。くわしくはRTX 4070(12GB)でローカルLLMはどこまで動く?にまとめています。
Q4_K_Mなどは、モデルを小さくする方式の名前です。同じモデルなら、小さいファイルのほうが少し速く、VRAMも少なめでした。まずはVRAMに収まるファイルを選び、質は自分の使い方で確かめます。
次に読む記事
この記事でできるようになったことQ4_K_Mなどが量子化の方式の名前だと分かり、VRAMに収まるファイルを選べる
やってみる使いたいモデルのファイル一覧で、量子化の名前と大きさを見比べ、VRAMに収まるものを1つ選ぶ
次に「自分のパソコンでAIを動かしたい。RTX 4070でどの大きさのモデルまで動くか分からない」と思ったら
ローカルLLMを試すRTX 4070で4つのモデルを測った速さほかの疑問なら
- LM Studioを始めるLM Studioはどう始める?という人に
- AIに必要なVRAMを知るAIに必要なVRAMは何GB?という人に
いまは「STEP 7 自分に合わせる」です。難しかった・違う悩みだった人は、START HERE の「困ったときは」から選べます。
参考
- Hugging Face Docs「GGUF」https://huggingface.co/docs/hub/gguf (2026年11月1日に確認)
- Google「gemma-4-12b-it-qat-q4_0-gguf」(Hugging Face)https://huggingface.co/google/gemma-4-12b-it-qat-q4_0-gguf (2026年11月1日に確認)
コメント