「LM Studioの設定にある『コンテキスト長』って何?大きくしたほうがいいの?」
この記事は、ローカルLLM(自分のパソコンで動かす文章AI)を動かすときに出てくる「コンテキスト長」の意味と、どれくらいに設定すればいいかを知りたい人のための記事です。LM Studioの始め方はLM Studioの始め方にまとめています。
先に結論です。
- コンテキスト長は、AIが文章を作るときに一度に考える長さ(トークンの数)の上限です。長い文章を渡すなら、大きくする必要があります
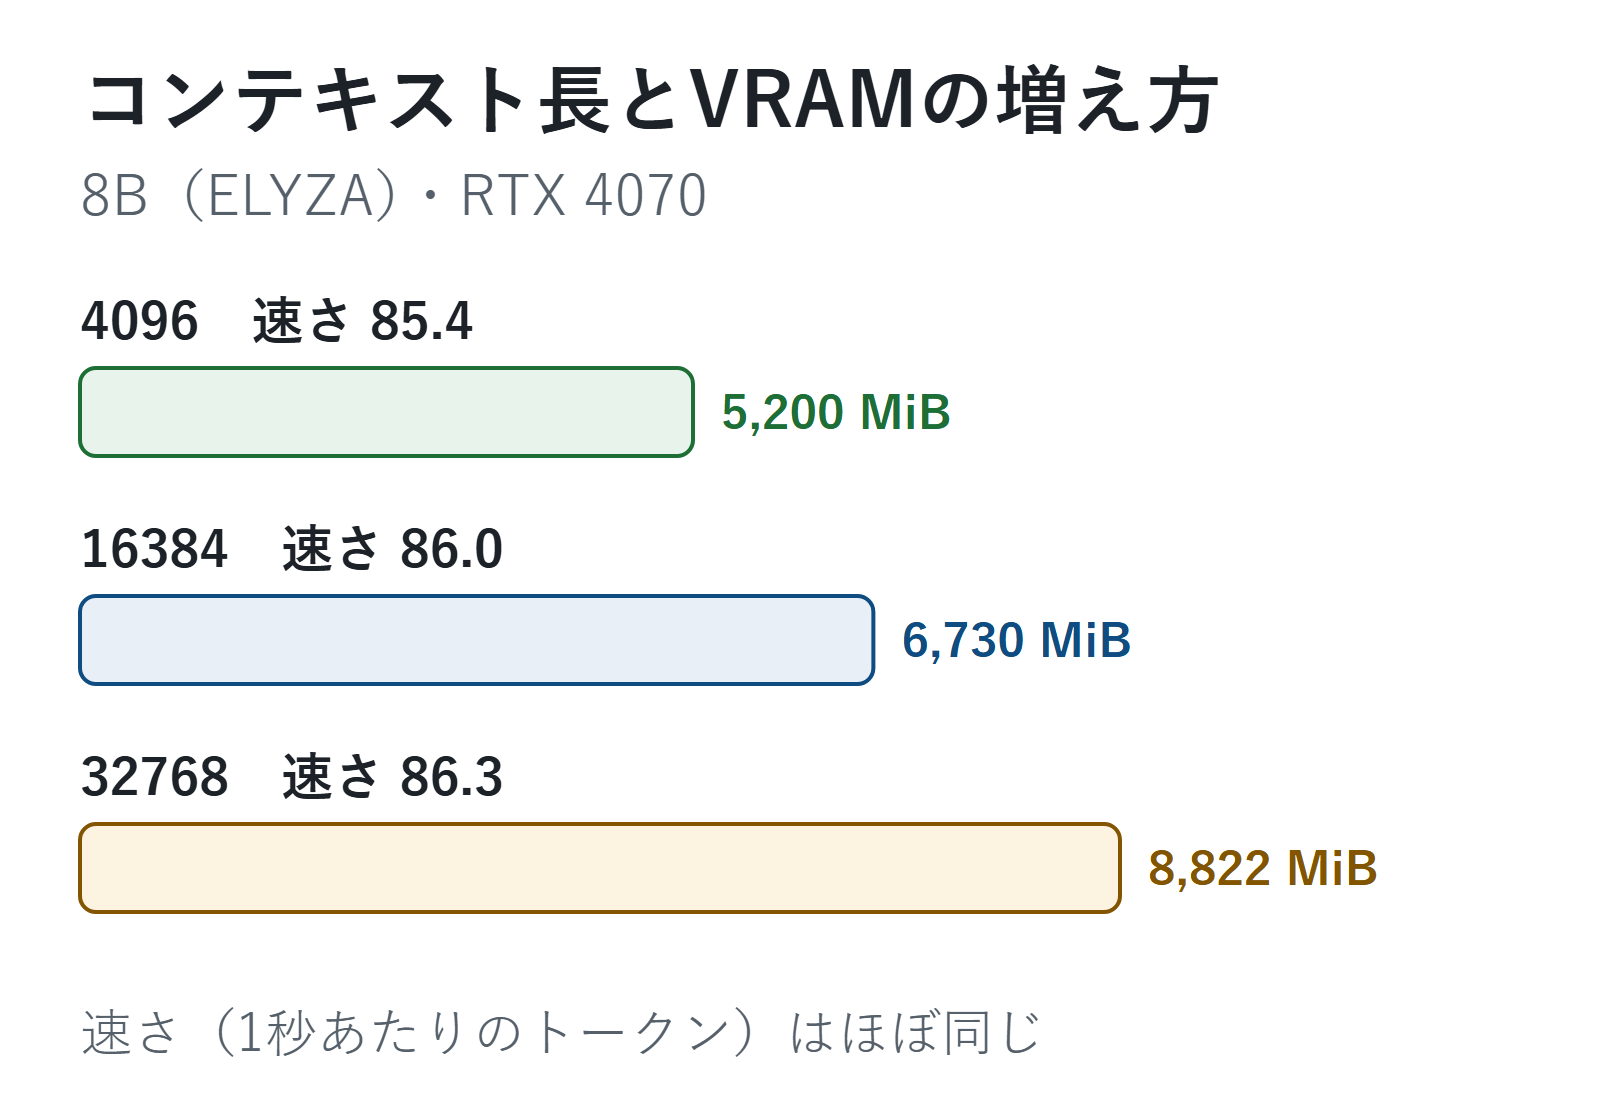
- 8Bのモデルで、コンテキスト長を4096から32768に増やすと、VRAMの増え方は5,200 MiBから8,822 MiBになりました
- 文章を出す速さは、どの長さでも1秒あたり約85〜86トークンで、ほとんど変わりませんでした
- 長い文章を扱わないなら、大きくしすぎず、VRAMに余裕を残します
2026年11月1日に、筆者のRTX 4070(12GB)のパソコンで、LM Studioを使って、同じ8Bのモデルをコンテキスト長だけ変えて読み込み、測りました。
あなたならどれで十分か
| 使い方 | コンテキスト長の目安 | 筆者の記録 |
|---|---|---|
| 短い質問や、短い文章の要約 | 小さめ(4096など)で足りる | 8BでVRAMの増え方が5,200 MiB |
| 長い文章をまとめて渡す | 渡す長さより大きく | 約4,300トークンの文章は、16384で扱えた |
| VRAMに余裕がないパソコン | 大きくしすぎない | 32768では、VRAMの増え方が8,822 MiB |
| どれくらい必要か分からない | 小さめから始めて、足りなければ増やす | 長さを変えても、速さはほぼ同じだった |
「トークン」は、AIが文章を区切って扱う単位です。今回の約4,300トークンの文章は、短いお知らせ(約150字)を40回つなげたものでした。
なぜそう言えるか:長さのぶん、先にVRAMを確保する
LM Studioのコマンドの説明では、コンテキスト長は「文章を作るときに、文脈として考えるトークンの数」とされています。会話が長くなったり、長い文章を渡したりすると、その分を一度に覚えておく必要があります。
今回の記録では、コンテキスト長を大きくして読み込んだだけで、VRAMの使用量が増えました。長い文章を実際に渡したあとも、VRAMの使用量はほとんど変わりませんでした。読み込みのときに、設定した長さの分を先に確保していると考えられます。
実際に試した結果
| コンテキスト長 | VRAMの増え方 | 速さ(1秒あたり) |
|---|---|---|
| 4096 | 5,200 MiB | 85.4トークン |
| 16384 | 6,730 MiB | 86.0トークン |
| 32768 | 8,822 MiB | 86.3トークン |
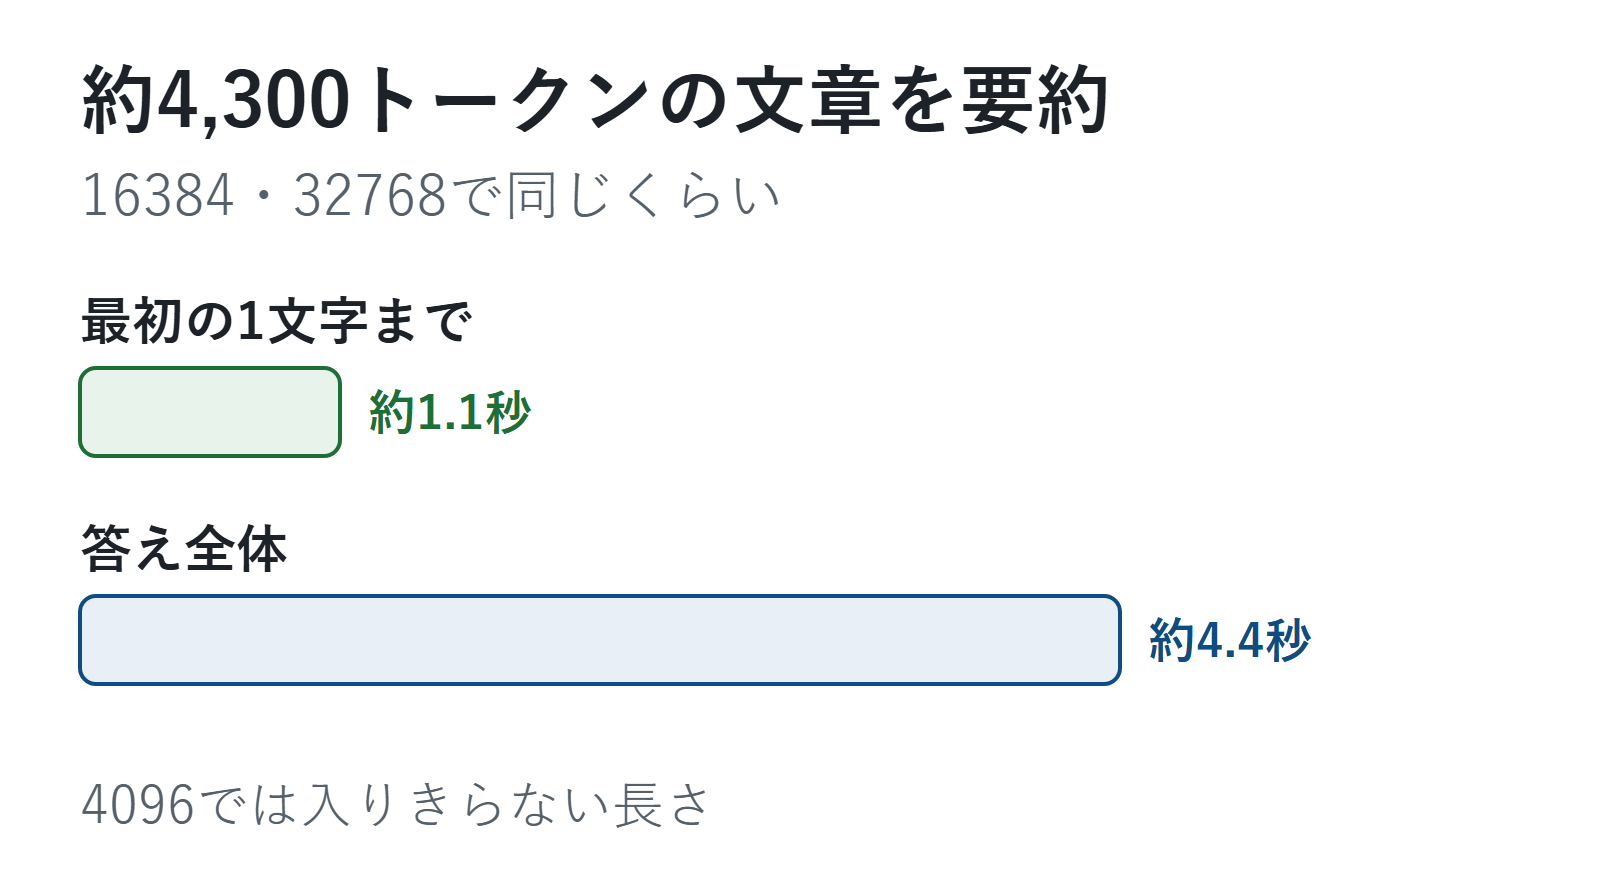
約4,300トークンの長い文章を渡して要約させると、16384と32768のどちらでも、最初の1文字が出るまで約1.1秒、全体で約4.4秒でした。4096では、この長さの文章は入りきらないので試していません。
32768で読み込んだときのVRAMの使用量は、全体で9,527 MiBでした。12GBのVRAMのうち、残りは3,000 MiB足らずです。もっと大きなモデルでコンテキスト長を伸ばすと、VRAMが足りなくなる可能性があります。
設定するときに見る場所
- 渡したい文章の長さ:長い文章や長い会話を扱うなら、その長さより大きくします
- 今のVRAMの空き:タスクマネージャーの「パフォーマンス」→「GPU」の「専用 GPU メモリ」で、読み込んだ後の使用量を見ます
- モデルの大きさ:大きいモデルほど、もとのVRAMの使用量が多いので、伸ばせる余地が減ります(RTX 4070(12GB)でローカルLLMはどこまで動く?)
よくある勘違い
- コンテキスト長は大きいほど速い → 今回、速さはほとんど変わりませんでした
- 長い文章を渡したときだけ、VRAMが増える → 今回は、読み込んだ時点でVRAMが増えていました
- 大きくしておけば損はない → VRAMを多く使うので、ほかの用途やモデルの大きさに響きます
よくある質問
Q. いくつに設定すればいいですか?
A. 渡す文章の長さで決めます。短い質問が中心なら小さめ、長い文章をまとめて渡すなら大きめにします。筆者の8Bでは、4096でVRAMの増え方が5,200 MiB、32768で8,822 MiBでした。
Q. VRAMが足りないときは?
A. コンテキスト長を小さくするか、小さいモデルや小さいファイル(量子化)を選びます。量子化の違いはGGUFの量子化(Q4_K_Mなど)とは?にまとめています。
コンテキスト長は、AIが一度に考える長さの上限です。大きくすると長い文章を扱える一方、VRAMを多く使うので、使い方に合わせて決めます。
次に読む記事
この記事でできるようになったことコンテキスト長の意味と、VRAMの増え方・速さへの影響が分かり、使い方に合わせて設定できる
やってみる渡したい文章の長さを見積もり、それより少し大きいコンテキスト長で読み込む
次に「ローカルLLMのファイル名にあるQ4_K_MやQ4_0の意味と、どれを選べばいいか分からない」と思ったら
量子化を知るQ4_K_Mなどの違いと3種類の比較ほかの疑問なら
- ローカルLLMを試すRTX 4070(12GB)でローカルLLMはどこまで動く?という人に
- AIに必要なVRAMを知るAIに必要なVRAMは何GB?という人に
いまは「STEP 7 自分に合わせる」です。難しかった・違う悩みだった人は、START HERE の「困ったときは」から選べます。
参考
- LM Studio Docs「Get started」https://lmstudio.ai/docs/app/basics (2026年11月1日に確認)
コメント