「VRAMが少ないパソコンでも動く、小さいローカルLLMって使えるの?」
この記事は、GPUのVRAMが少ないパソコンや、GPUのないパソコンで、ローカルLLM(自分のパソコンで動かす文章AI)を試したい人が、小さいモデルでどこまでできるかを知るための記事です。同じ頼み方を8BとChatGPTで比べた結果は、ローカルLLMとChatGPTはどう違う?にまとめています。
先に結論です。
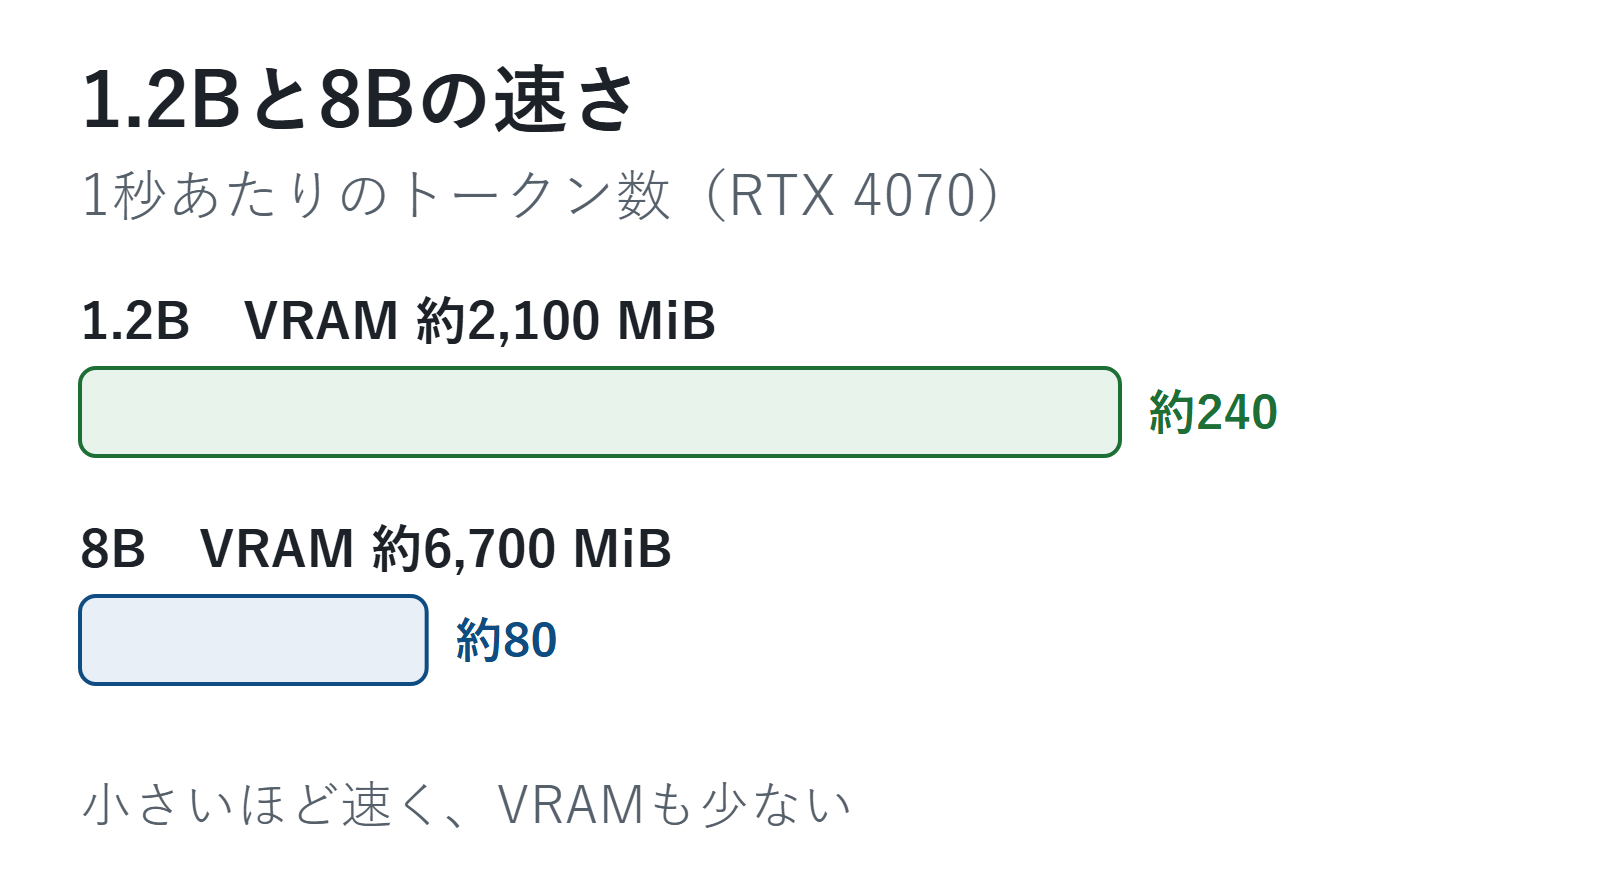
- 1.2Bの日本語モデル(ファイル約1.3GB)は、VRAMを全体で約2,100 MiB使い、1秒あたり約240トークンと速く動きました
- 要約は、お知らせの点をすべて含めて答えました(ただし「3行」の形ではありませんでした)
- 富士山の標高は3,776mと正しく答えましたが、どの機関の値かを間違えました
- 小さいモデルは、手元で文章の下書きや要約を試すのに使えます。事実の答えは、必ず確かめます
2026年11月1日に、筆者のRTX 4070のパソコンで、LM StudioのLFM2.5-1.2B-JPを使って、同じ3つの頼み方を1回ずつ試しました。
あなたならどれで十分か
| やりたいこと | 1.2Bで足りるか | 筆者の記録 |
|---|---|---|
| ローカルLLMを、まず動かしてみる | 足りる | VRAM約2,100 MiB、GPUなしでも1秒あたり約28トークン |
| 短い文章の要約 | 試せる | 点はすべて含んだが、形の指定は守らなかった |
| 事実を答えてもらう | 確かめが必須 | 標高の値は正しく、機関を間違えた |
| メールの下書き | 手直しが要る | お願いの中身が変わっていた |
どれも各1回の結果です。同じモデルでも、頼み方や設定で答えは変わります。
なぜそう言えるか:小さいモデルは軽いが、知識と指示の守り方に限りがある
モデルの大きさ(「1.2B」「8B」の数字)は、モデルの中の数値の多さを表します。小さいモデルは、ファイルもVRAMの使用量も小さく、速く動きます。筆者のパソコンでは、1.2Bは8Bの約3倍の速さでした。
一方で、今回の3問では、1.2Bは事実の出どころを間違え、メールのお願いの中身も変わっていました。8Bでも要約で点が抜けたり、メールが長くなったりしたので、どの大きさでも、答えを確かめてから使う点は同じです。
実際に試した結果
| 頼み方 | 1.2B | 8B(参考) |
|---|---|---|
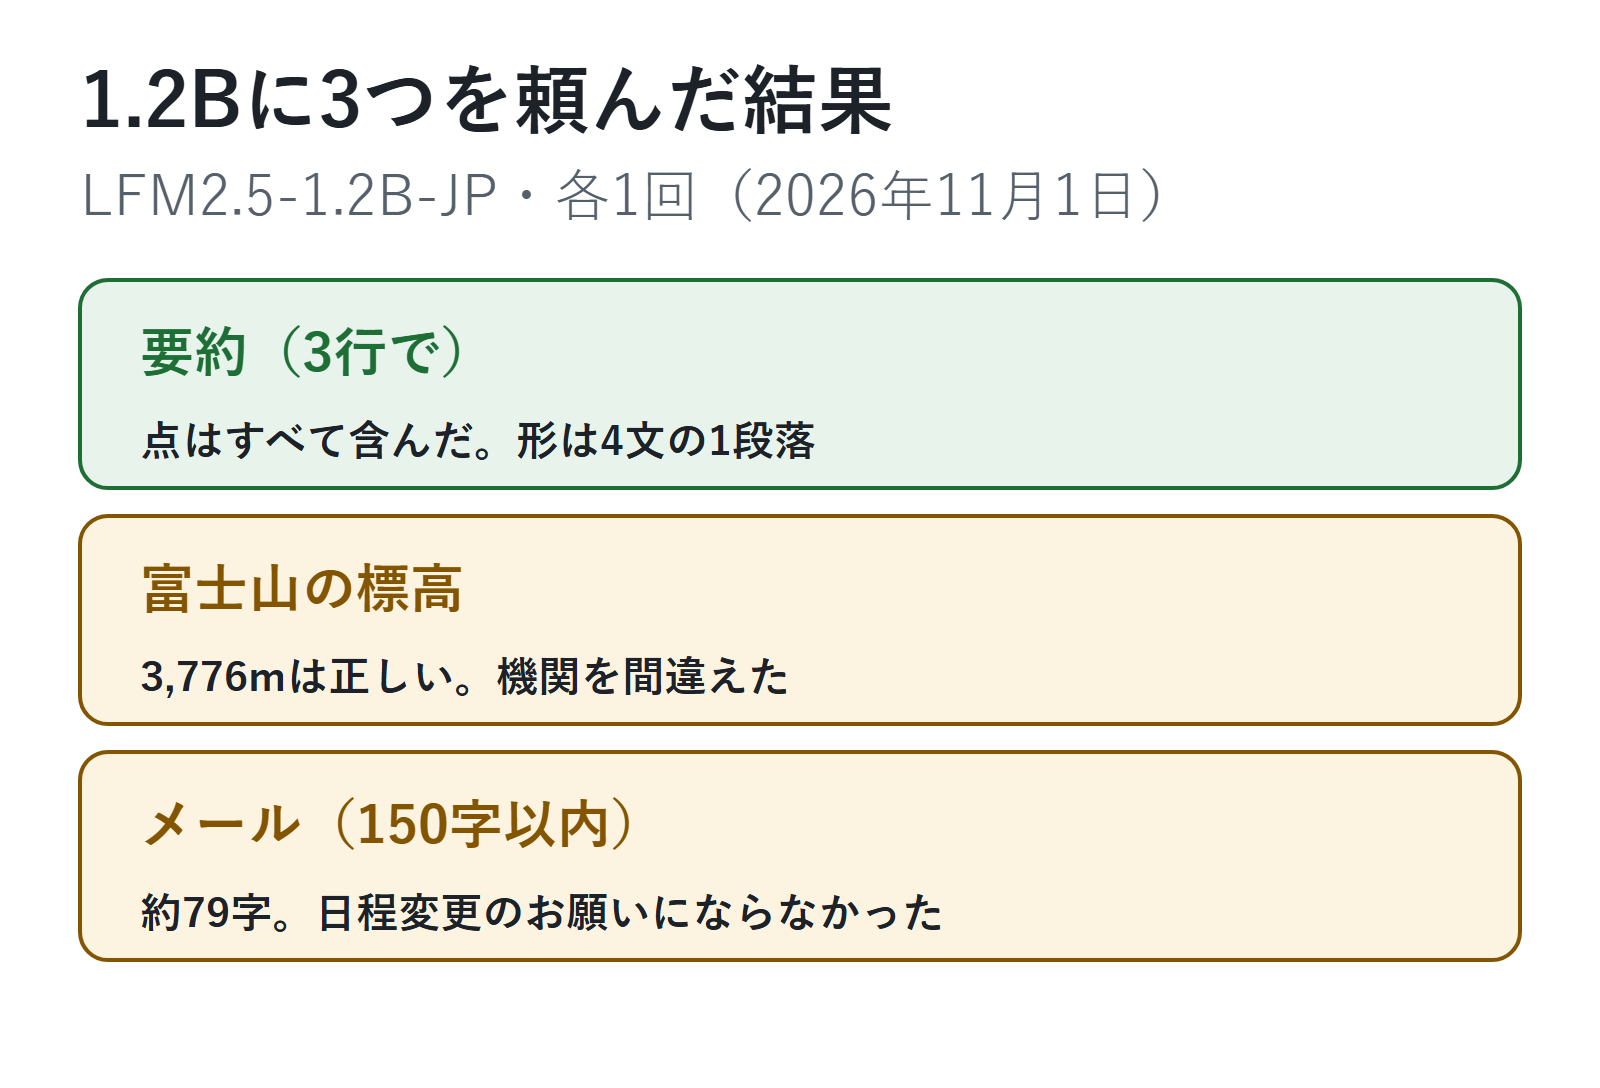
| お知らせを3行で要約 | 4文の1段落。点はすべて含んだ | 3文の1段落。2つの点が抜けた |
| 富士山の標高と、どの機関の値か | 3,776m。機関を「日本気象協会(現・気象庁)」と答えた | 3776m・国土地理院 |
| 日程変更のお願いメール(150字以内) | 約79字。相手の都合を聞く文になった | 168字で上限を超えた |
1.2Bの答えは、3問とも2〜3秒で返りました。速くて軽いぶん、答えの中身は1つずつ確かめる必要がありました。
使うときに見る場所
- 今のVRAMとメモリ:1.2BはVRAMを全体で約2,100 MiB使いました。GPUがなければ、CPUだけでも動きます(GPUなし(CPUだけ)でローカルLLMは動く?)
- 用事:下書きや要約を試すなら、小さいモデルから始められます
- 事実の確かめ方:答えの数字や出どころは、公式の情報で確かめます(生成AIの答えはどこまで信じていい?)
よくある勘違い
- 小さいモデルは、要約もできない → 今回は、お知らせの点をすべて含めて要約しました
- 数字が合っていれば、出どころも正しい → 標高の値は正しく、機関は間違えていました
- 速いモデルほど、答えもよい → 今回、速さと答えのよさは一致しませんでした
よくある質問
Q. VRAMが4GBくらいのパソコンでも動きますか?
A. 筆者のパソコンでは、1.2BはVRAMを全体で約2,100 MiB使いました。ほかのパソコンでは試していないので、まず動かして、タスクマネージャーでVRAMの使用量を見てください。始め方はLM Studioの始め方にまとめています。
Q. もっと大きいモデルとの違いは?
A. 8Bとの比較は上の表のとおりです。どの大きさまで動くかはRTX 4070(12GB)でローカルLLMはどこまで動く?にまとめています。
小さい1.2Bのモデルは、VRAMの少ないパソコンでも速く動き、要約も試せました。ただ、事実の出どころを間違えたので、答えは確かめてから使います。
次に読む記事
この記事でできるようになったこと小さいモデルの速さ・VRAMと、要約・事実・メールでの得意不得意が分かり、使いどころを決められる
やってみる小さいモデルで短い文章の要約を頼み、答えの事実を自分で確かめる
次に「自分のパソコンで動くAIとChatGPTで、答えがどれくらい違うか知りたい」と思ったら
ChatGPTと比べる同じ3つの頼み方の結果ほかの疑問なら
- GPUなしで動かすGPUなし(CPUだけ)でローカルLLMは動く?という人に
- AIの答えを確かめるAIの答えを信じていいか分からないという人に
いまは「STEP 7 自分に合わせる」です。難しかった・違う悩みだった人は、START HERE の「困ったときは」から選べます。
参考
- 国土地理院「衛星測位を基盤とする三角点「富士山」の新しい標高」https://www.gsi.go.jp/WNEW/PRESS-RELEASE/keikaku61003.html (2026年11月1日に確認)
コメント