「ネットに出さずに、自分のパソコンでAIを動かしたい。RTX 4070で、どのくらいの大きさのモデルまで動くの?」
この記事は、ローカルLLM(自分のパソコンで動かす文章AI)を試したい人が、RTX 4070(VRAM 12GB)でどこまで動くかを判断するための記事です。VRAMの基本は、AIに必要なVRAMは何GB?にまとめています。
先に結論です。
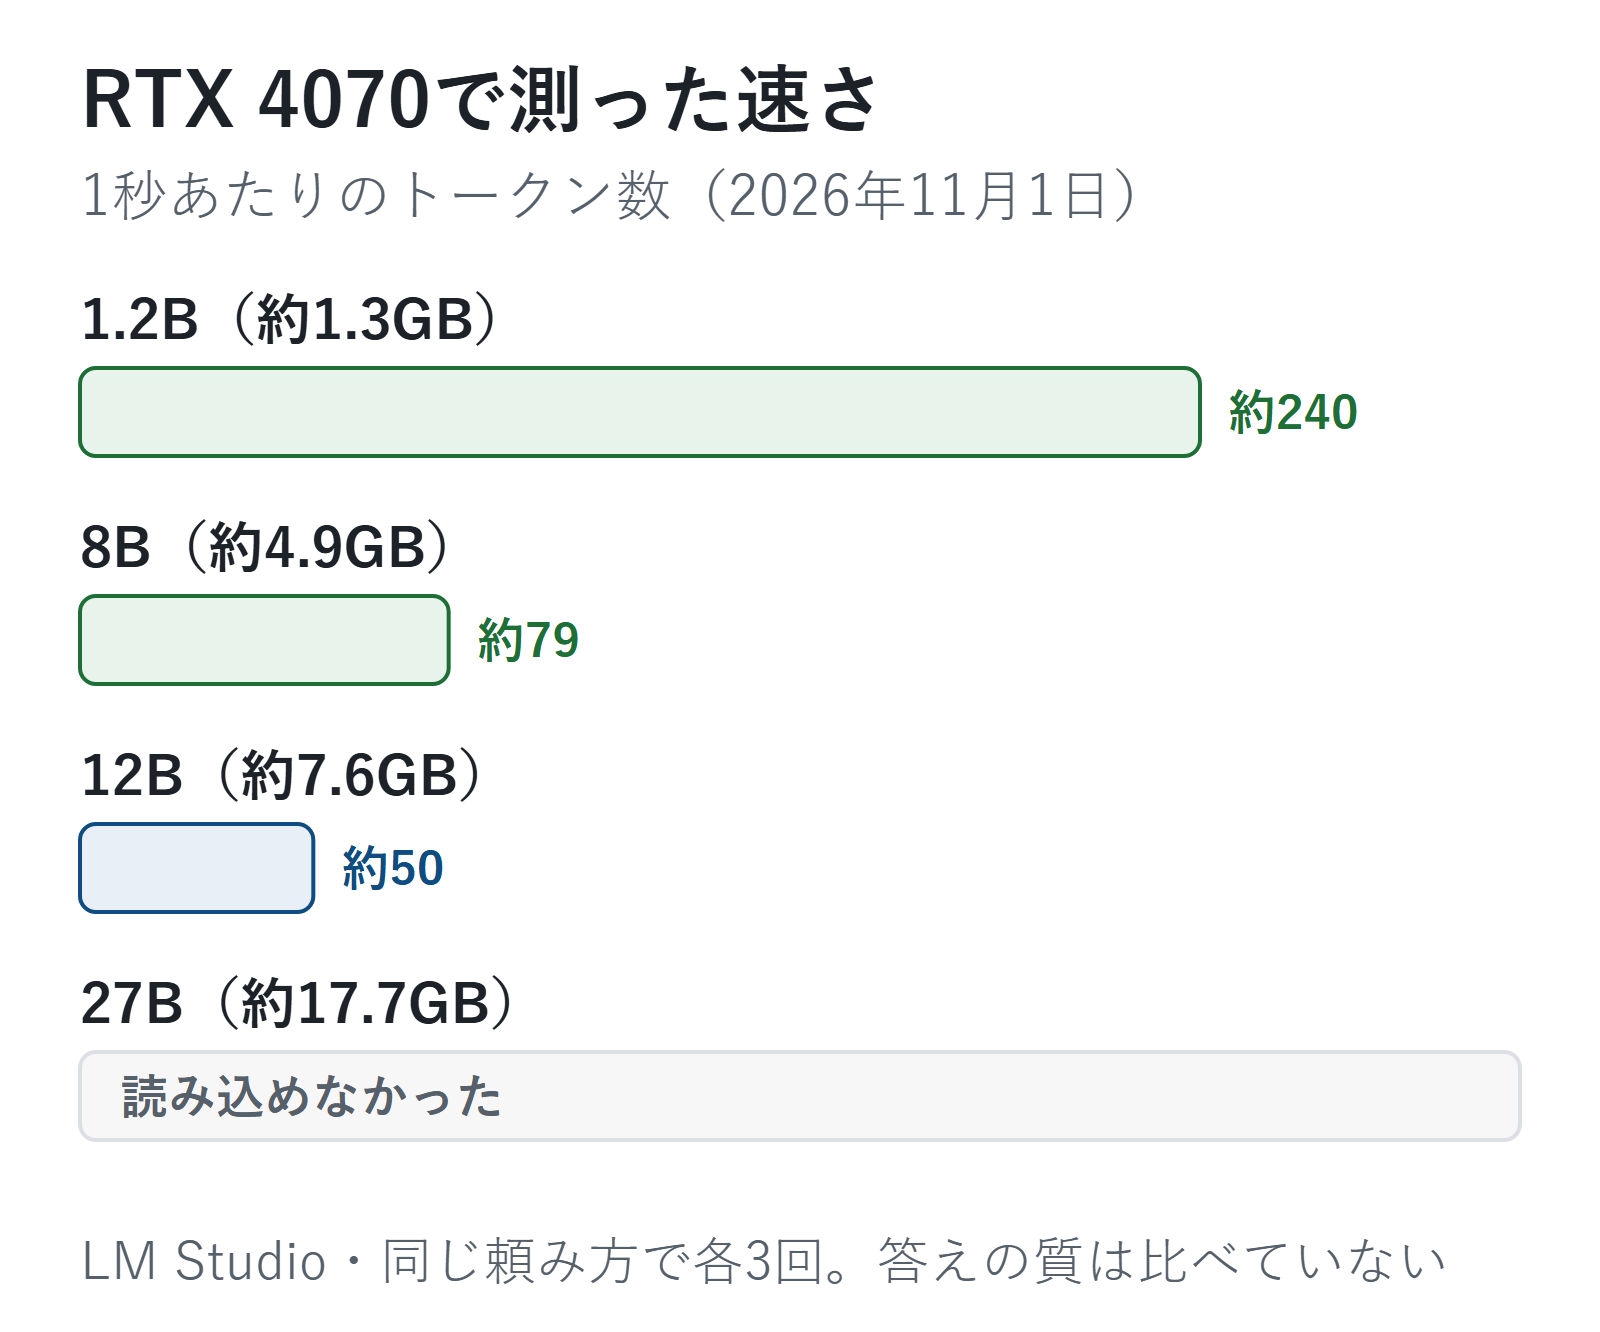
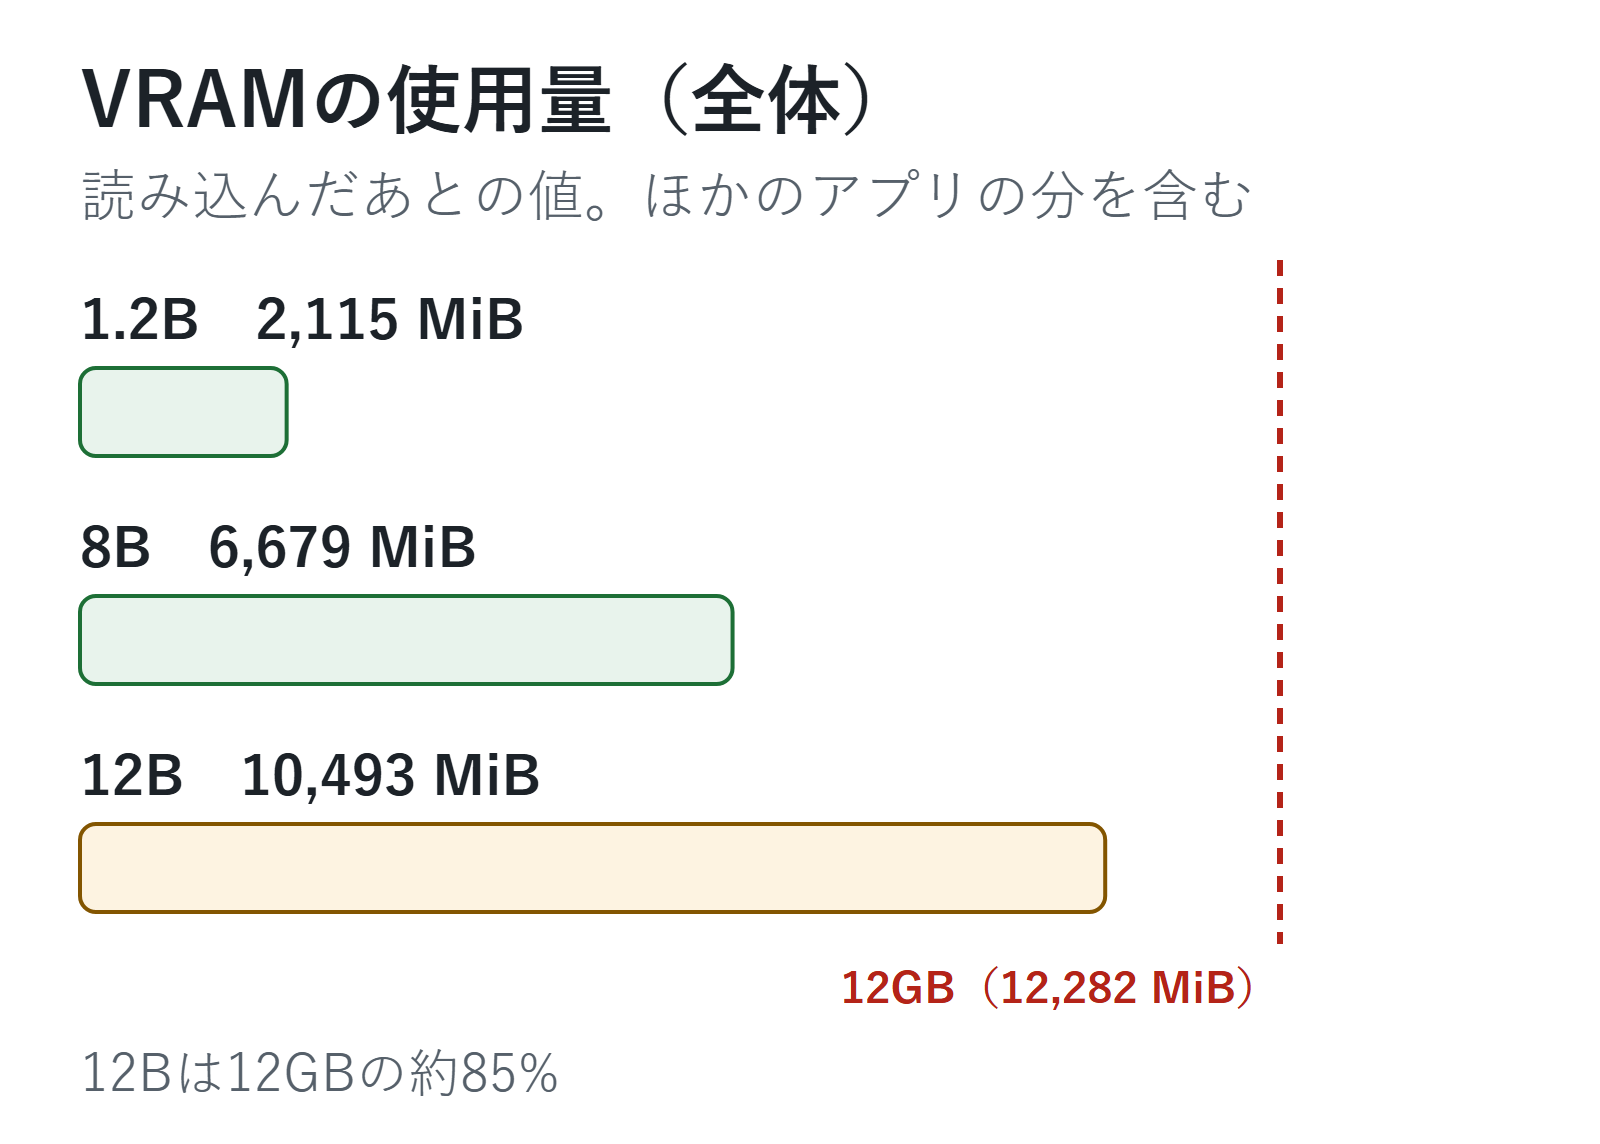
- 8B(ファイル約4.9GB)は、1秒あたり約79トークンで、VRAMは全体で6,679 MiBでした。余裕をもって動きます
- 12B(ファイル約7.6GB)は、1秒あたり約50トークンで、VRAMは全体で10,493 MiB(12GBの約85%)まで使いました。上限に近づきます
- 27B(ファイル約17.7GB)は、今回は読み込みの途中で止まり、動かせませんでした
- RTX 4070で試すなら、まず8B前後のモデルから始めるのが無理のない範囲です
2026年11月1日に、筆者のRTX 4070のパソコンで、LM Studioというアプリを使い、4つのモデルに同じ頼み方をして測りました。速さだけを測り、答えの質は比べていません。
あなたならどれで十分か
| やりたいこと | モデルの大きさの目安 | 筆者の記録 |
|---|---|---|
| まず動かしてみたい | 1B〜8B | 8Bで1秒あたり約79トークン。VRAMは6,679 MiB |
| もう少し大きいモデルを使いたい | 12B前後 | 1秒あたり約50トークン。VRAMは10,493 MiBで、上限に近い |
| 27B以上の大きなモデル | 12GBでは厳しい | 27Bは今回、読み込めなかった |
| ふだんの調べものや文章 | ローカルでなくてよい | ChatGPTなどは、サービスのサーバーで動く |
「B」は、モデルの大きさ(パラメータの数)を表す単位で、8Bなら80億です。同じ大きさのモデルでも、ファイルの大きさは、小さくする方式(量子化)によって変わります。量子化の違いで速さがどう変わるかは、GGUFの量子化(Q4_K_Mなど)とは?で比べました。
なぜそう言えるか:ファイルの大きさとVRAM
ローカルLLMは、モデルのデータをGPUのVRAMに載せて動かします。モデルのファイルがVRAMに収まれば速く動き、収まらない分はメモリ(RAM)に置くことになります。
今回の記録では、12Bはファイルが約7.6GBで、VRAMは全体で10,493 MiB(12GBの約85%)まで使いました。この値には、読み込む前からデスクトップなどが使っていた分(611〜1,482 MiB)も含みます。VRAMには、モデルのファイルのほかにも、会話の途中のデータなどが載ります。
LM Studioの公式の動作要件では、Windowsで「メモリ16GB」「VRAM 4GB」をそれぞれ最低限の目安としてすすめています。
実際に試した結果
| モデル(ファイル) | VRAM(全体) | 速さ(1秒あたり、3回) |
|---|---|---|
| LFM2.5 1.2B JP(約1.3GB) | 2,115 MiB | 130.5・237.8・243.6 |
| Llama-3-ELYZA-JP-8B(約4.9GB) | 6,679 MiB | 80.8・78.3・79.1 |
| gemma-4-12B(約7.6GB) | 10,493 MiB | 50.8・49.3・50.1 |
| Qwen3.8-27B(約17.7GB) | 読み込めず | 測れず |
測った条件は次のとおりです。
- パソコン:RTX 4070(VRAM 12GB)、Core i7-13700F、メモリ32GB、Windows 11
- アプリ:LM Studio(始め方はLM Studioの始め方)。会話の長さの上限(コンテキスト)は4096(意味と、長さを変えたときのVRAMはローカルLLMの「コンテキスト長」とは?)、GPUに載せる割合は自動
- 頼み方:「ChatGPTで文章を要約してもらうときのコツを、日本語で5つ、箇条書きで」。毎回同じ答えになりやすい設定で、各3回
- ほかのアプリは開いたままで、使えるメモリは約11〜14GBでした
27Bは、自動の設定でも、GPUに載せる割合を半分にした設定でも、読み込みの途中で止まりました。エラーに理由は表示されず、原因は分かっていません。ほかのアプリを開いたままで、そのとき使えたメモリは約11〜14GBでした。
別の環境の記録として、筆者のRTX 4090環境(VRAM 24GB、メモリ約64GB)では、約63GB・約71GBの大きなモデルを、VRAMとメモリを合わせて動かした記録があります。モデルも環境も違うので、今回の速さとは比べられません。くわしくは筆者のもう1つのブログのRTX 4090で約70GBのローカルLLMは動く?にまとめています。
買うときに見る場所
- VRAMの量:使いたいモデルのファイルの大きさより、余裕のあるVRAMを選びます。筆者の12GBでは、ファイル約7.6GBの12Bで、VRAMの約85%を使いました
- メモリの量:VRAMに入りきらない分はメモリに置きます。大きなモデルを使うなら、メモリにも余裕が要ります。筆者の記録はAIに使うならメモリは32GB?64GB?
- GPUの型番:VRAMの多いGPUの例は、RTX 4060・4070・4090はAIで何が違う?
よくある勘違い
- VRAMが12GBあれば、12GBのモデルが動く → ファイル約7.6GBの12Bで、VRAMは全体で10,493 MiBまで使いました
- 速いモデルほど、答えがよい → 今回は速さだけを測りました。答えのよさは別に確かめる必要があります
- ローカルLLMなら、ChatGPTと同じことができる → 今回のモデルとChatGPTは比べていません。ふだんの用事なら、ChatGPTなどのサービスで足ります
よくある質問
Q. ローカルLLMは何に使えますか?
A. ネットに出したくない文章を、手元で扱いたいときに向きます。今回の8Bや1.2Bは、日本語の箇条書きで答えを返しました。ChatGPTと同じ頼み方で比べた結果は、ローカルLLMとChatGPTはどう違う?にまとめています。答えの正しさは、ほかのAIと同じように確かめてから使います。確かめ方は生成AIの答えはどこまで信じていい?にまとめています。
Q. RTX 4070でも、27Bを動かす方法はありますか?
A. 筆者は今回、27Bを読み込めませんでした。ほかのアプリを閉じてメモリの空きを増やしたときにどうなるかは、試していません。
RTX 4070(12GB)なら、8B前後のモデルは余裕をもって動き、12B前後は上限に近づきます。それより大きなモデルを使うなら、VRAMとメモリの両方を増やすことを考えます。
VRAM約2GBで動く軽いモデルでできることは軽いローカルLLM(1.2B)でどこまでできる?、GPUを使わずに動かした結果はGPUなし(CPUだけ)でローカルLLMは動く?、動かしたときの電気代はローカルAIの電気代はいくら?にまとめています。
次に読む記事
この記事でできるようになったことRTX 4070(12GB)で動くモデルの大きさの目安と速さが分かり、自分のPCで試すモデルを選べる
やってみる今のパソコンのVRAMを確かめ、使いたいモデルのファイルの大きさと比べる
次に「AIのためにパソコンを買う・メモリを足すときに、メモリが何GBあればいいか分からない」と思ったら
メモリの量を決める32GBで止まった記録と64GBの空きほかの疑問なら
- LM Studioを始めるLM Studioはどう始める?という人に
- AIに必要なVRAMを知るAIに必要なVRAMは何GB?という人に
- GPUの型番を比べるRTX 4060・4070・4090はAIで何が違う?という人に
いまは「STEP 7 自分に合わせる」です。難しかった・違う悩みだった人は、START HERE の「困ったときは」から選べます。
参考
- LM Studio「System Requirements」https://lmstudio.ai/docs/app/system-requirements (2026年11月1日に確認)
コメント