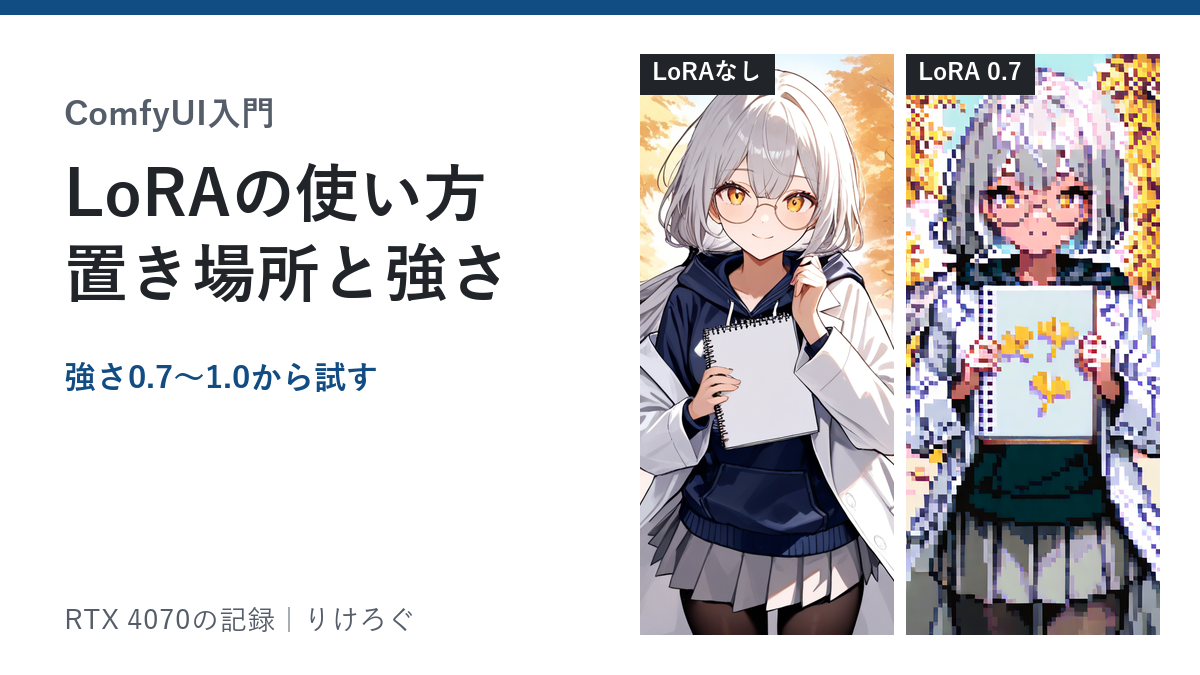
「LoRAをダウンロードしたけど、どこに入れて、どのノードにつなげばいいの?」
この記事は、ComfyUIで最初の1枚を作れた人が、LoRA(ローラ)を使って絵柄を変えられるようになるための記事です。
LoRAは絵を描くモデル(Checkpoint)に、画風やキャラクターの特徴を足すための小さな追加ファイルです。わたしはRTX 4070(12GB)のPCで、アニメ向けのモデル「Animagine XL 4.0」に、ドット絵のLoRAと、少ないステップで描ける高速化のLoRAを入れて、強さや組み合わせを変えながら試しました。
先に結論です。
- LoRAは「models/loras」フォルダに置き、「LoRAを読み込む」ノードを、Checkpointの後ろにつなぎます
- 強さ(モデルの強度)は0.7〜1.0から始めるのがおすすめです。今回のドット絵のLoRAは、1.2以上で顔がつぶれました
- トリガーワードを入れないと、ほとんど効かないLoRAもあります。配布ページで確かめてください
- LoRAはベースモデル(元にしたモデル)と同じ系統のものを使います。SD1.5用のLoRAをSDXL系のモデルにつないでも、画面にエラーは出ないので気づきにくいです
LoRAとは?Checkpointとの違い
画像生成のモデルには大きく2種類あります。
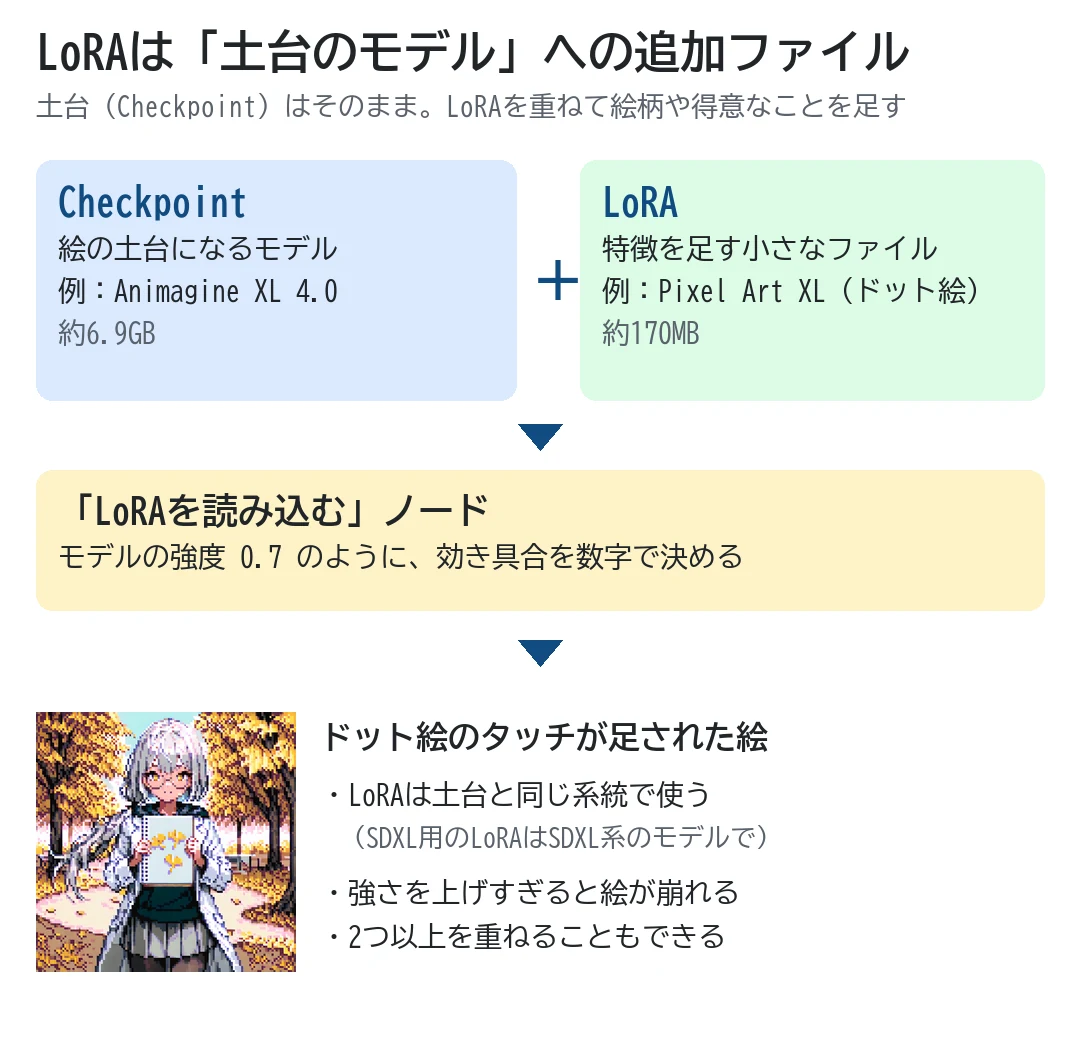
- Checkpoint:絵の描き方を全部覚えているモデル。数GBある。Animagine XL 4.0やIllustrious XLなど
- LoRA:Checkpointに足したい特徴だけを覚えた追加ファイル。数十〜数百MB。「ドット絵にする」「この服を着せる」「少ないステップで描く」など
ComfyUIの公式ドキュメントでも、LoRAは「モデル全体を学習し直さずに、一部だけを調整する」方法と説明されています。Checkpointはそのままで、LoRAを付け替えるだけで絵柄を変えられるのが便利なところです。
ひとつだけ大事な決まりがあります。LoRAは作られたときのモデル(ベースモデル)と同じ系統で使います。SDXL用のLoRAなら、SDXLや、それを元にしたAnimagine XL・Illustrious XLなどが対象です。SD1.5用のLoRAはSDXL系では効きません(あとで実際に試します)。
今回使ったLoRAと環境
LoRAは、ライセンスと作者がはっきりしているHugging Faceの2つを使いました。
- Pixel Art XL(作者はnerijs):絵をドット絵のタッチにするSDXL用のLoRA。170MB。ライセンスはCreativeML Open RAIL-M
- LCM-LoRA SDXL(latent-consistency):4〜8ステップで描けるようにするSDXL用のLoRA。394MB。ライセンスはOpen RAIL++
環境はRTX 4070(12GB)・メモリ32GB・Windows 11、ComfyUI 0.30.0です。CheckpointはAnimagine XL 4.0を使いました。
絵は白衣と眼鏡のオリジナルキャラで、seedは303、28ステップ、CFG 5、1024×1024にそろえています。
CivitAIなどで探すと、もっとたくさんのLoRAが見つかります。ただ、版権キャラや実在の人物を再現するLoRAも多いので、配布ページのライセンスと、何を学習したものかを確かめてから使ってください。
手順1:LoRAを置く
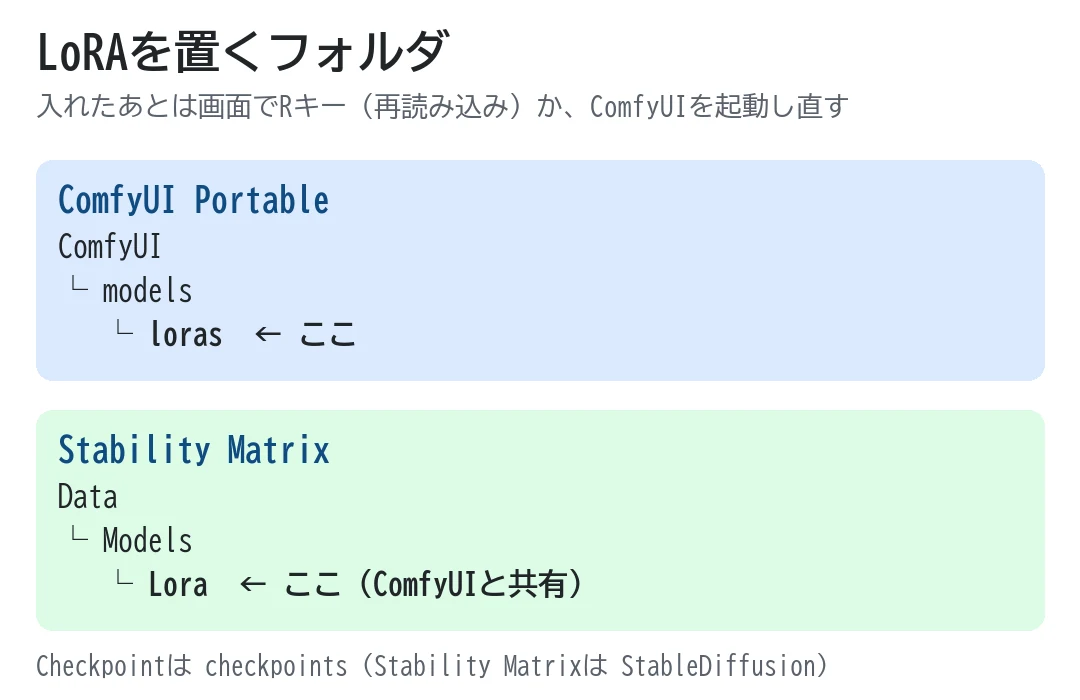
ダウンロードしたLoRA(拡張子は.safetensors)を、次のフォルダに入れます。
- ComfyUI Portable:ComfyUI\models\loras
- Stability Matrix:Data\Models\Lora(Stability Matrixから入れたComfyUIは、ここを見に行く)
ComfyUIを起動したまま入れたときは、画面をクリックしてからキーボードのRを押すと、一覧が読み込み直されます。出てこなければComfyUIを起動し直してください。
Stability Matrixのフォルダの名前は、ComfyUIの説明と違うことがあります。対応はStability Matrixの使い方にまとめています。
手順2:「LoRAを読み込む」をつなぐ
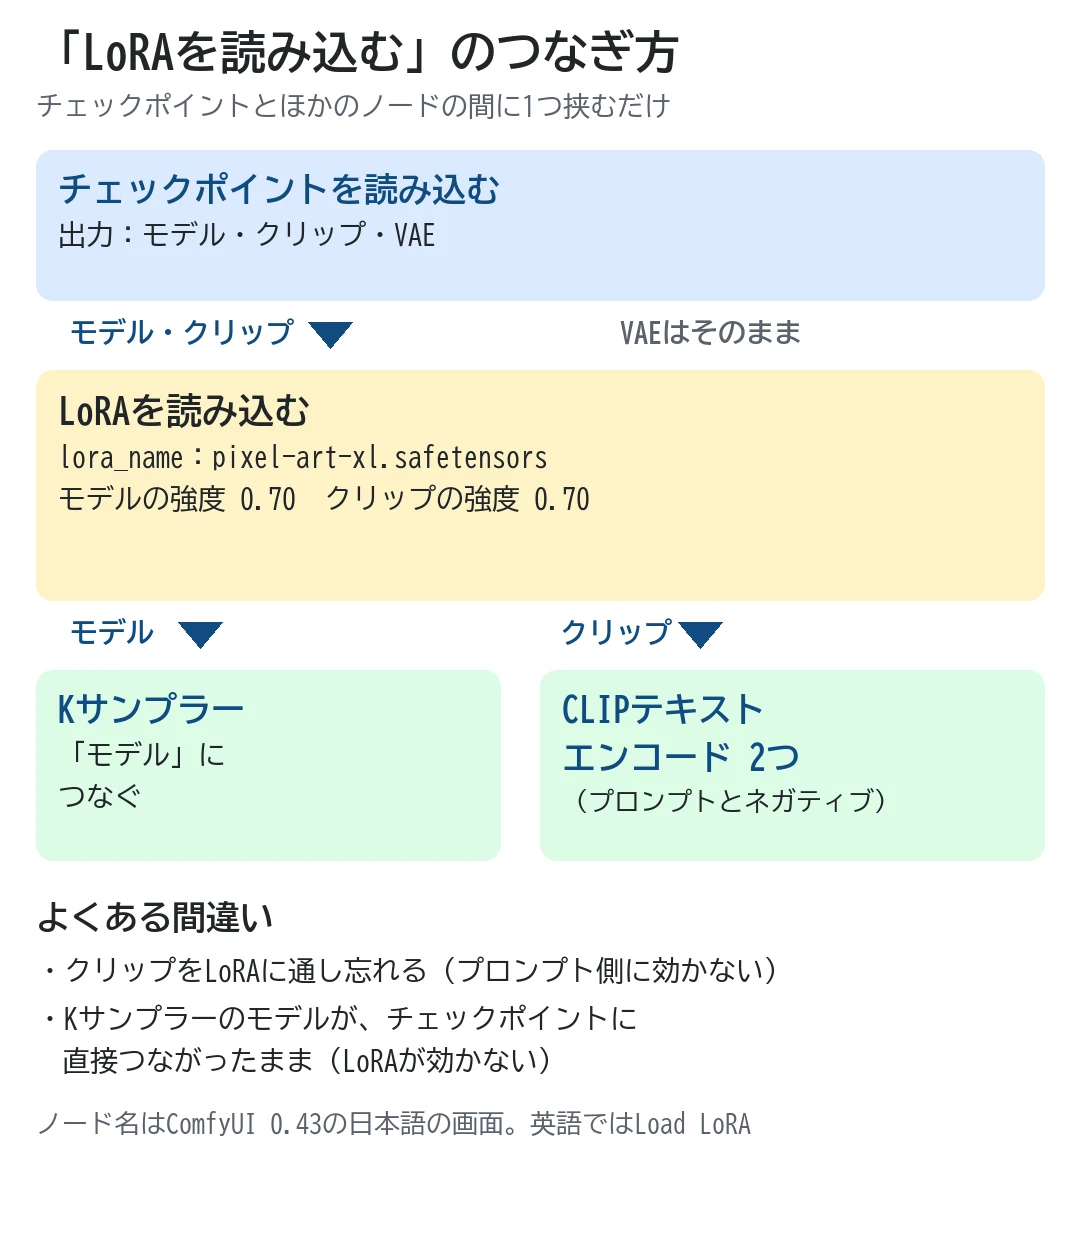
最初の1枚のワークフローに、ノードを1つ足すだけです。
- 画面の何もない所をダブルクリックして「LoRA」と入力し、候補の中から、かっこの付かない「LoRAを読み込む」を選ぶ
- 「チェックポイントを読み込む」の「モデル」と「クリップ」を、「LoRAを読み込む」の左の「モデル」「クリップ」につなぐ
- 「LoRAを読み込む」の右の「モデル」を「Kサンプラー」へ、「クリップ」を2つの「CLIPテキストエンコード」(プロンプトとネガティブ)へつなぎ直す
- 「lora_name」で入れたLoRAを選び、「モデルの強度」と「クリップの強度」を決める
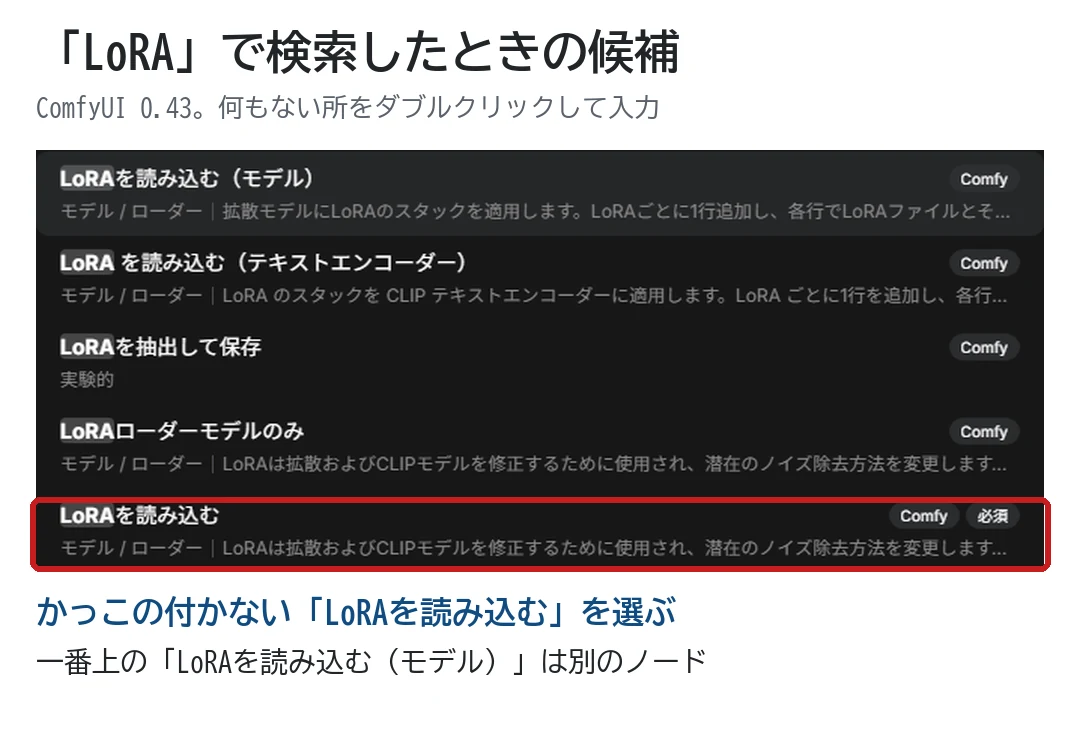
候補の一番上に出る「LoRAを読み込む(モデル)」は、LoRAをまとめて並べる別のノードです。この記事では、かっこの付かない「LoRAを読み込む」を使います(ComfyUI 0.43で確認)。
Checkpointから直接つながっていた線を、LoRAを通るようにつなぎ直すのが大事です。クリップを通し忘れると、プロンプトの側にLoRAが効きません。
ノード名は、ComfyUI 0.43の日本語の画面での表示です。英語の画面では「Load LoRA」です。
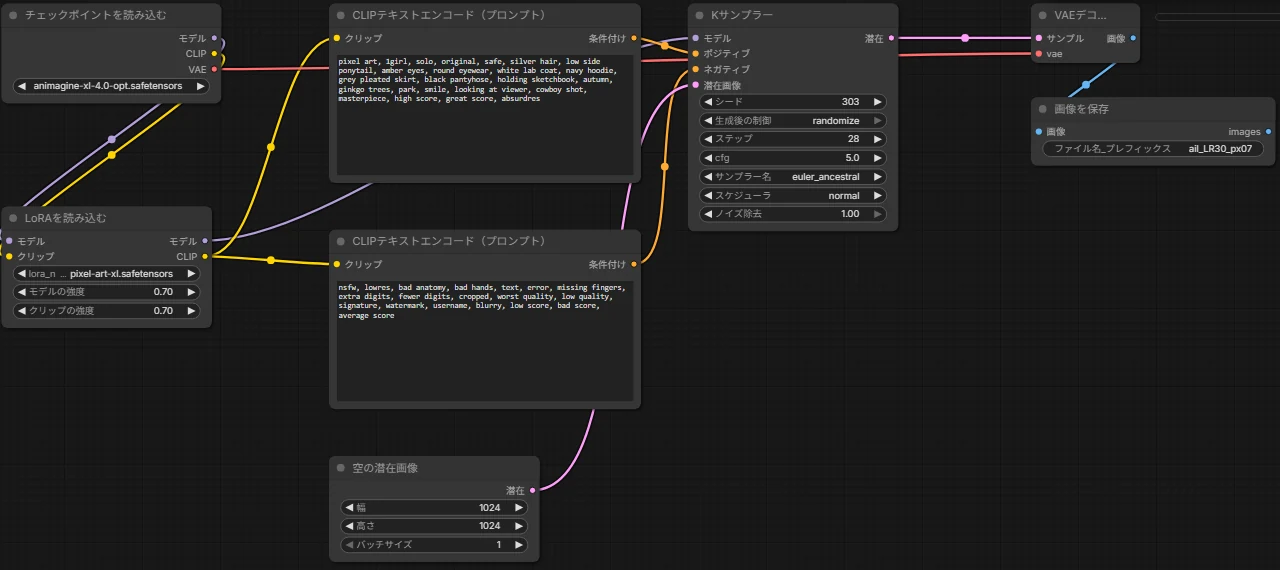
実際の画面ではこうなります(パソコンの大きな画面で見ると、線のつながりが分かりやすいです)。
手順3:トリガーワードを入れる
LoRAには、プロンプトに入れると効きやすくなる言葉(トリガーワード)が決まっているものがあります。配布ページに書かれていることが多く、Pixel Art XLでは「pixel art」でした。
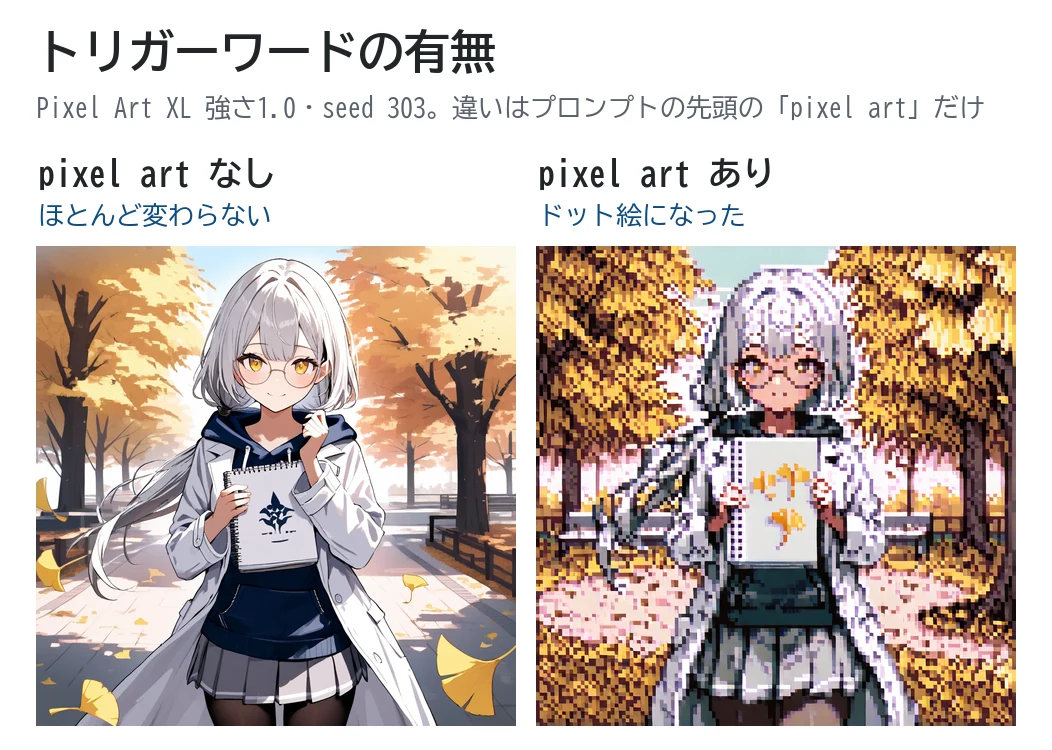
強さ1.0でも、プロンプトに「pixel art」を入れないと、絵はほとんど変わりませんでした。入れると、はっきりドット絵になりました。
LoRAが効かないと思ったら、まず配布ページでトリガーワードを確かめて、プロンプトの先頭に入れてみてください。
強さを変えると、どう変わる?
「モデルの強度」を0から1.5まで変えて、同じseedで比べました。クリップの強度も同じ値にしています。
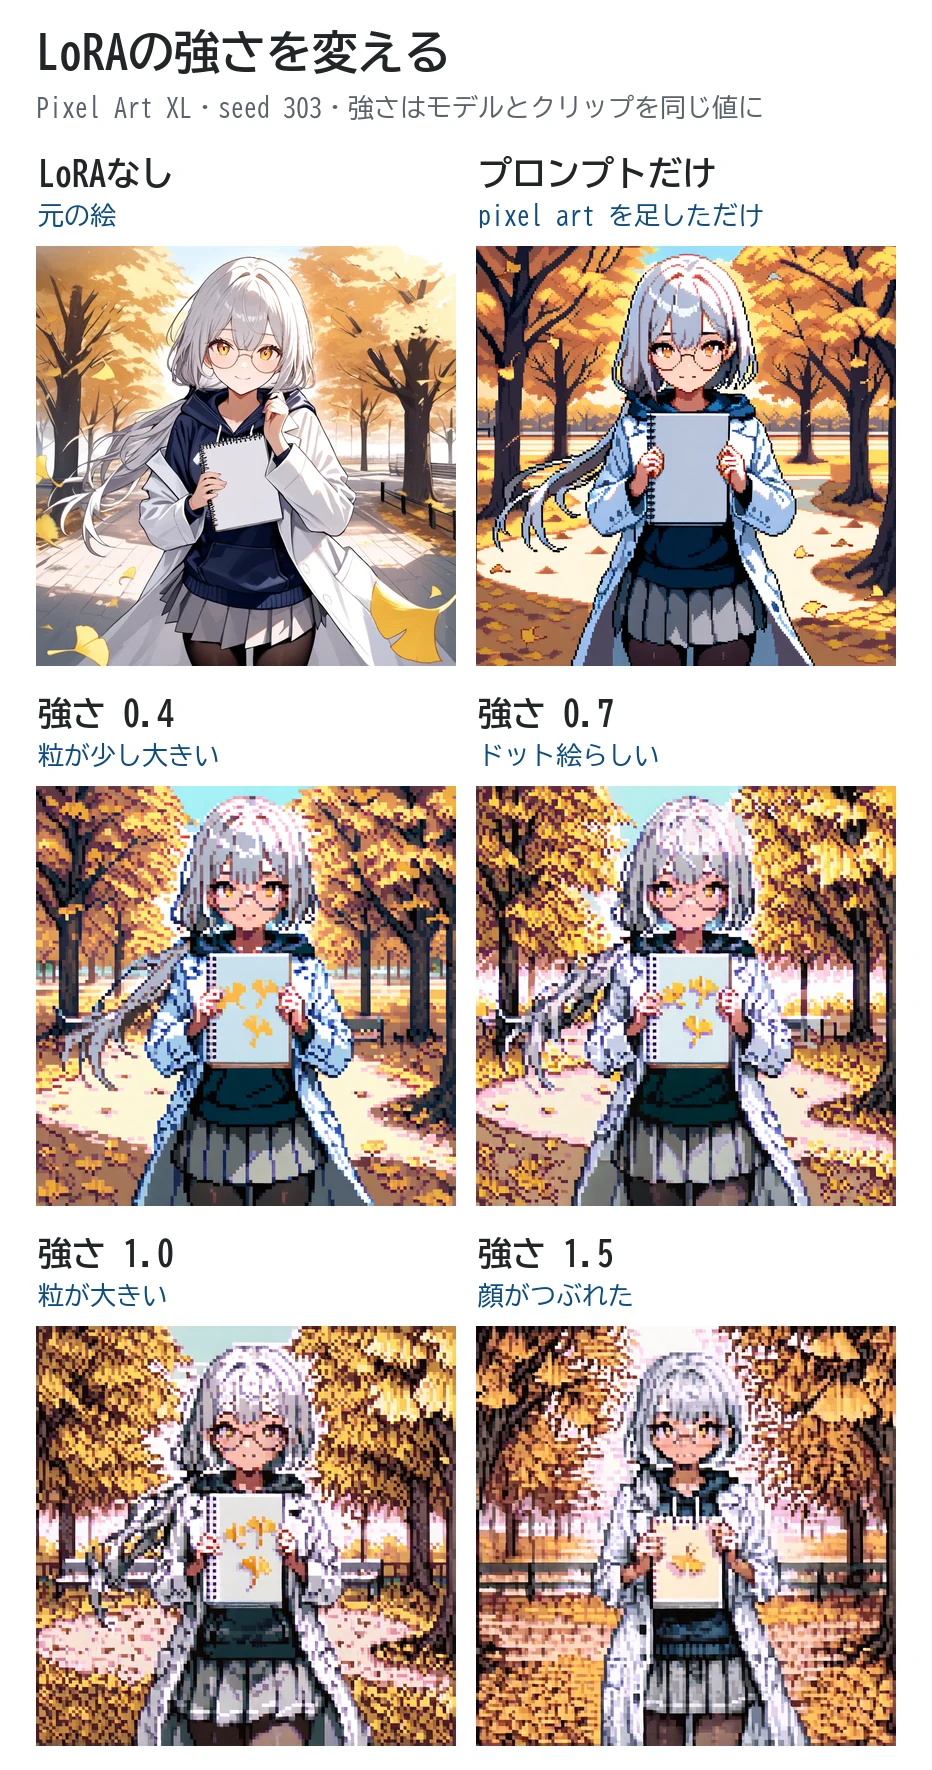
- 強さ0.4:ドットの粒が少し大きくなった
- 強さ0.7:ドット絵らしい粗さになり、顔もきれい
- 強さ1.0:粒がさらに大きくなった
- 強さ1.2〜1.5:顔や手がつぶれて、全体が暗くなった
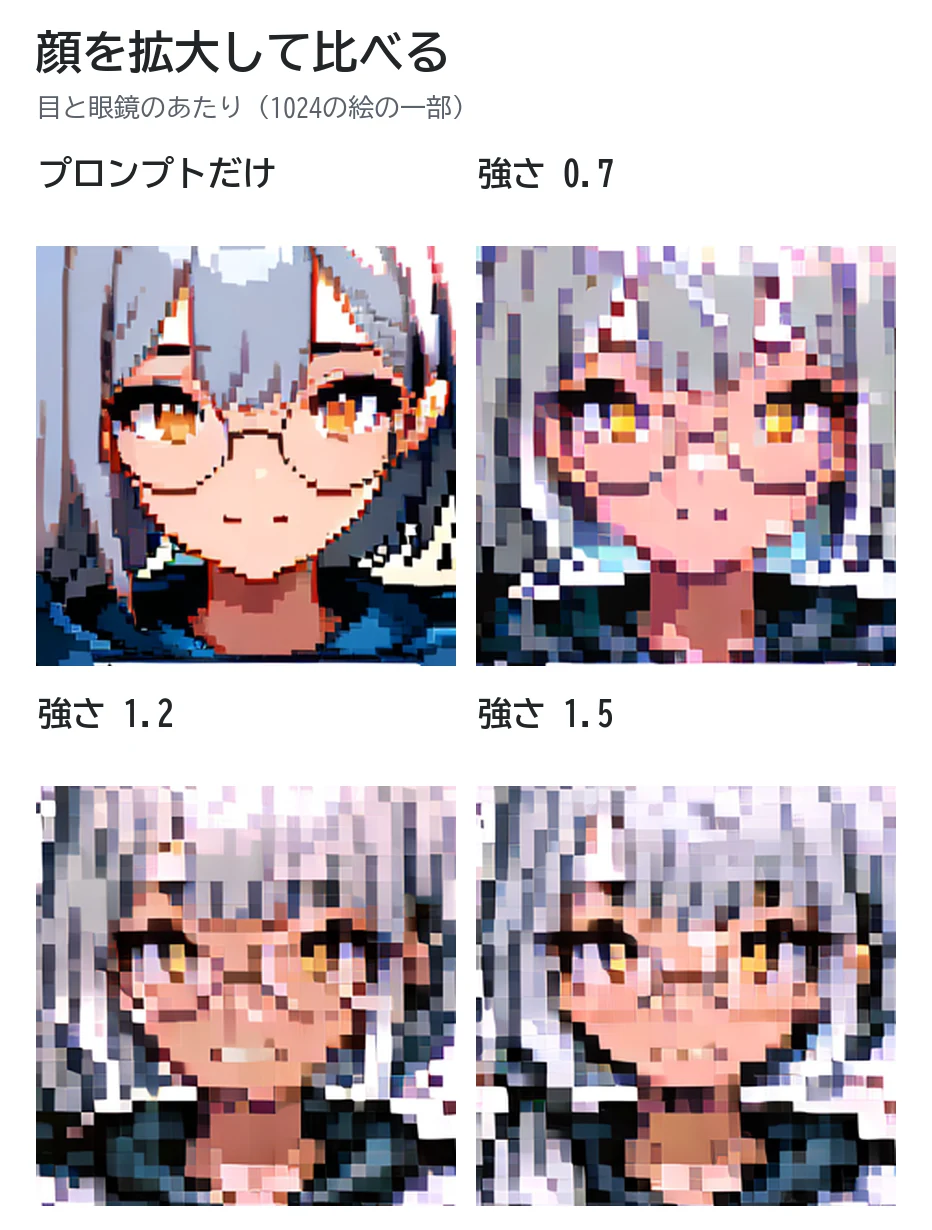
顔を拡大すると違いがよく分かります。0.7までは目と眼鏡の形が残っていますが、1.2からは眼鏡の線が消えて、口元も崩れました。
配布ページには「強さ1.2がよい」とありますが、これは高速化のLoRA(あとで試すLCM-LoRA)と組み合わせて8ステップで描くときの値です。いつもの28ステップでは、0.7〜1.0がちょうどよく感じました。
強さの目安はLoRAによって違います。初めて使うLoRAは、0.7で1枚、1.0で1枚作って比べるのがおすすめです。
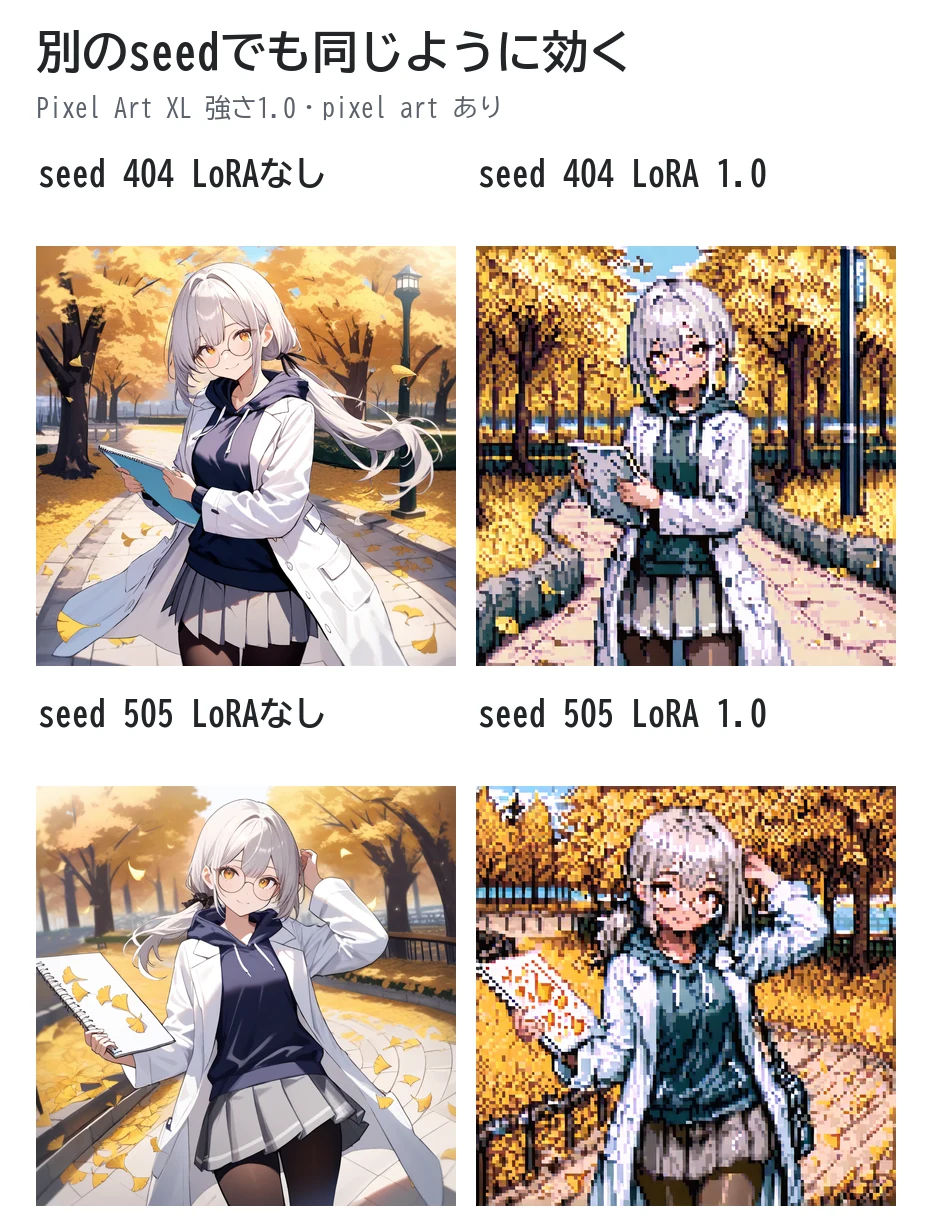
seedを変えても、同じようにドット絵になりました。
LoRAの前に、プロンプトだけで出せないか試す
さきほどの比較では、LoRAを使わず、プロンプトに「pixel art」を足しただけでも、Animagine XL 4.0はドット絵風の絵を描きました。
- プロンプトだけ:ドットが細かく、きれいにまとまった「ドット絵風」
- LoRAを使う:ドットの粒が大きく、ゲームの画面のような粗い「ドット絵」
Animagine XL 4.0はもともと「pixel art」という言葉を知っているモデルでした。欲しいのが「ドット絵っぽい雰囲気」くらいなら、LoRAは要りません。
LoRAを探す前に、まずプロンプトで出せないか試してみると、手間もファイルも増やさずに済みます。プロンプトでは出せない絵柄や、細かい特徴を足したいときにLoRAを使う、という順番がおすすめです。
設定も変えるLoRA(高速化のLCM-LoRA)
LoRAには絵柄ではなく「描き方」を変えるものもあります。LCM-LoRAは、ふつうは28ステップほどかかる絵を、4〜8ステップで描けるようにするLoRAです。
このタイプはLoRAをつなぐだけでは使えません。配布ページの説明に合わせて、Kサンプラーの設定も変えます。
- ステップ:4〜8
- cfg:1〜2
- サンプラー名:lcm(ComfyUIでの設定。スケジューラはsgm_uniformにした)
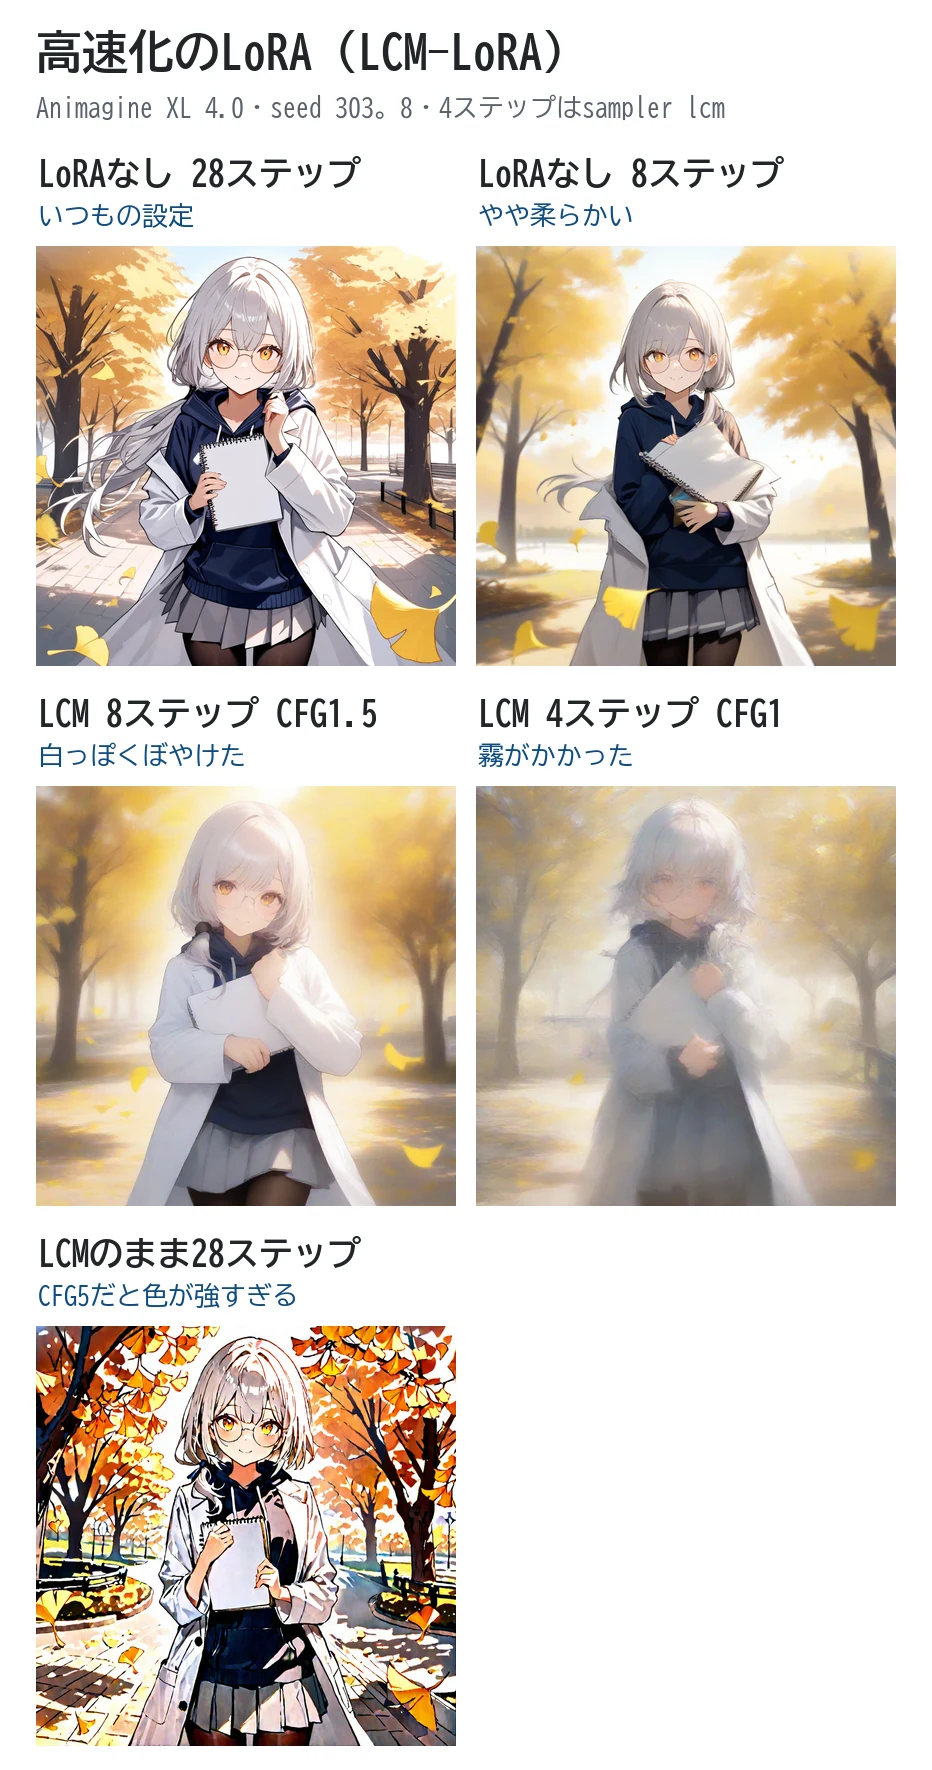
結果は期待どおりではありませんでした。
- LCM 8ステップ:全体が白っぽく、ぼやけた
- LCM 4ステップ:霧がかかったようになった
- LoRAなしの8ステップ:少し柔らかいが、LCMの8ステップよりはっきりしていた
LCM-LoRAはSDXLの元のモデル(SDXL 1.0)に合わせて作られたLoRAです。Animagine XL 4.0はSDXLを元にしたモデルなので読み込めますが、絵柄との相性はよくありませんでした。同じ系統のLoRAでも、組み合わせるCheckpointによって結果が変わる例です。
LoRAを2つ重ねる
「LoRAを読み込む」はつなげて並べられます。1つ目の右の「モデル」「クリップ」を、2つ目の左につなぐだけです。ComfyUIの公式ドキュメントでも、この方法で2つのLoRAを同時に使っています。
Pixel Art XLの配布ページには「LCM-LoRAと組み合わせて、8ステップ・CFG 1.5・強さ1.2」という使い方が書かれていたので、そのとおりに重ねてみました。
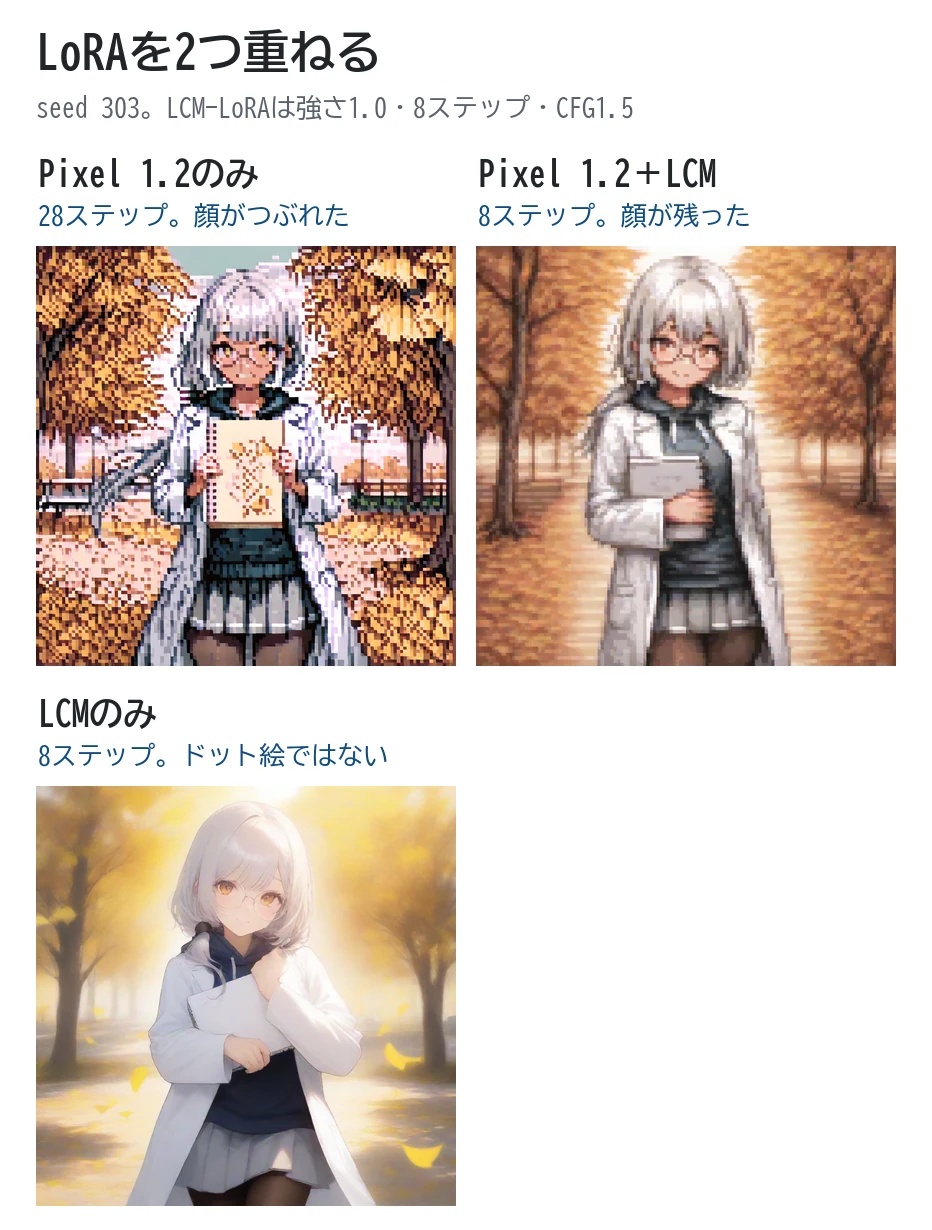
- Pixel Art XL 1.2だけ(28ステップ):顔がつぶれた
- Pixel Art XL 1.2+LCM-LoRA(8ステップ):顔が残り、柔らかいドット絵になった
- LCM-LoRAだけ(8ステップ):ドット絵にはならない
同じ強さ1.2でも、組み合わせとステップ数で結果が変わりました。配布ページに推奨の設定が書かれているときは、まずそのとおりに試すのが近道です。
うまくいかなかった例
SD1.5用のLoRAをSDXL系に入れた
2023年に入れたSD1.5用のLoRA(細部を増やすタイプ)を、Animagine XL 4.0につないでみました。
ComfyUIの画面にはエラーが出ず、そのまま生成が始まりました。ただ、ComfyUIを起動した黒い画面(ログ)には「lora key not loaded」という警告が288行出ていました。LoRAの中身がCheckpointの形に合わず、読み込めなかった部分がある、という意味です。
今回はこの直後に、パソコンのメモリ不足で生成が止まってしまい、絵を比べることはできませんでした。それでも、LoRAが効かないと感じたら、黒い画面にこの警告が出ていないかを見ると、系統の違いに気づけます。
ComfyUIの公式ドキュメントも、SD1.5・SDXL・FLUXなど系統の違うモデルを混ぜないように、と案内しています。LoRAを落とすときは、配布ページの「Base Model」(SDXL・Illustrious・Pony・SD 1.5など)を確かめてください。
高速化のLoRAを入れたまま、いつもの設定で描いた
LCM-LoRAをつないだまま、ステップを28・cfgを5に戻して描くと、色とコントラストが強すぎる絵になりました(上のLCMの比較の最後の1枚)。LoRAを外すのを忘れて、「なんだか色がきつい」と悩むパターンです。設定を変えるタイプのLoRAは、使い終わったらノードごと外しておくと安心です。
強さを上げすぎた
強さ1.2〜1.5で顔がつぶれたのは、さきほど見たとおりです。効きが弱いと感じても、いきなり1.5にせず、0.1〜0.2ずつ上げてください。
時間とVRAM
VRAM(GPUのメモリ)はどの回も最大で約8〜10GBでした(ほかのアプリの分も含むGPU全体の値)。LoRAを1つ足しても、2つ重ねても、12GBのGPUで止まることはありませんでした。LoRAのファイルは170〜394MBと小さいので、VRAMが足りなくなる心配はあまりなさそうです。
時間は、注意が要る結果になりました。
- LoRAをつないだまま、同じLoRA・同じ強さで続けて描く2枚目以降:28ステップで約10〜21秒(LoRAなしは約10秒)
- LoRAや強さを変えた直後の1枚目:約70〜270秒
今回はパソコンで別の作業を並べて動かしていたため、メモリ(RAM)の空きが1〜2GBしかない状態で測りました。LoRAを付け替えると、ComfyUIはモデルの重みを計算し直すので、メモリが足りないとこの部分がとても遅くなったと考えています。メモリに余裕がある状態では、もっと短くなるはずですが、今回は測れていません。
LoRAを試すときは、ブラウザのタブなどを閉じてメモリを空けておくと、待ち時間が短くなりそうです。必要なメモリの目安はAIイラストに必要なPCスペックにまとめています。
よくある質問
「モデルの強度」と「クリップの強度」は何が違う?
モデルの強度は絵を描く本体(拡散モデル)への効き具合、クリップの強度はプロンプトを読み取る部分への効き具合です。まずは両方を同じ値にして、強さを変えるときも一緒に動かすのが分かりやすいです。
一覧にLoRAが出てこない
置いたフォルダが違うか、一覧が古いままです。フォルダを確かめて、画面でRを押すか、ComfyUIを起動し直してください。拡張子が.safetensorsか、ダウンロードが途中で止まっていないか(ファイルの大きさ)も確かめます。フォルダが2か所に分かれてしまう原因と確かめ方は、ComfyUIのモデルはどこに置く?にまとめています。
ほかのエラーで止まったときは、ComfyUIのエラー早見表で、エラー文の言葉から原因を探せます。
CivitAIのLoRAを使っても大丈夫?
CivitAIには多くのLoRAがありますが、版権キャラクターや実在の人物を再現するもの、成人向けのものも混ざっています。配布ページで、ライセンス(商用利用の可否など)と、何を学習したLoRAかを確かめてから使ってください。わたしは記事の作例に、ライセンスと作者がはっきりしているLoRAだけを使っています。
まとめ
LoRAはmodels/lorasに置いて、「LoRAを読み込む」をCheckpointの後ろにつなぐだけで使えます。強さは0.7〜1.0から始めて、崩れたら下げてください。効かないときは、トリガーワードと、CheckpointとLoRAの系統(SD1.5用かSDXL用か)を確かめます。
次に読む記事
この記事でできるようになったことComfyUIでLoRAを入れて、強さを変えながら絵柄を変えられる
やってみる手持ちのLoRAで、強さ0.7と1.0の絵を1枚ずつ作って比べる
次に「ポーズも思いどおりにしたい」と思ったら
ポーズと構図を決めるControlNetの使い方2026ほかの疑問なら
- 絵を2倍にして細かく描き直すComfyUIでHires.fix
- 土台のモデルを選び直すアニメ向けモデルの比較
- 同じキャラで何枚も作る4つのやり方を試した
ローカルの画像生成の記事は、AI画像生成ガイドに、つまずく順にまとめています。
参考
どれも2026年11月2日に確認しました。
- ComfyUI公式ドキュメントのLoRAの説明:置き場所と「Load LoRA」ノード、複数のLoRAをつなげること
- Pixel Art XL(Hugging Face):トリガーワード、推奨の強さ、ライセンス
- LCM-LoRA SDXL(Hugging Face):ステップ数とCFGの目安、ライセンス
- ComfyUI公式ドキュメントの複数のLoRAの説明:2つのLoRAをつないで使う例
- ComfyUI公式ドキュメントのモデルの問題の説明:系統の違うモデルを混ぜない
- 実測:RTX 4070(12GB)・メモリ32GBのPC、ComfyUI 0.30.0
コメント