「AIにお客さん役をさせれば、市場調査はいらなくなる?」
こんな話がSNSで広まっています。元になっているのは、歯みがき粉で知られるColgate-Palmolive(コルゲート)の社員と、データ分析会社PyMC Labsの研究者が2025年10月に公開した論文です。
先に結論です。論文の結果は「AIに数字を直接聞かず、文章で答えさせてから点数に直すと、人間のアンケートにかなり近づいた」というもので、内容はしっかりしています。ただし論文自身が「人の調査の完全な代わりではない」と書いています。「市場調査が終わった」は言いすぎです。
この記事では、論文を読んで分かったことを、専門用語をできるだけ使わずに整理します。わたしは論文を読んだだけで、同じ実験はしていません。数字はすべて論文からの引用です。
この記事の要点
- AIに「1〜5で点数をつけて」と聞くと、ほぼ「3」ばかりになる
- 「感想を文章で書かせる→意味の近さで点数にする(SSR)」と、人間の答え方にかなり近づいた
- 年齢・収入による違いは比較的よく再現。性別・地域は不十分
- 試したのは米国の日用品(パーソナルケア)57調査だけ
論文の基本情報
- 題名:LLMs Reproduce Human Purchase Intent via Semantic Similarity Elicitation of Likert Ratings(arXiv 2510.08338)
- 著者:Benjamin F. Maier ほか(PyMC Labs)、Colgate-Palmolive の研究者2名
- 公開:2025年10月9日(最新は2025年10月27日の第3版)
- 種類:arXiv の論文(プレプリント)。学術誌の査読を通ったという記載は見つけられませんでした
- コード:論文に書かれた GitHub(pymc-labs/semantic-similarity-rating)で公開。ライセンスは Apache-2.0
- 確認日:2026年11月22日
「プレプリント」は、専門家の審査を受ける前に公開された論文のことです。中身が間違っているという意味ではありませんが、ほかの研究者による確認はこれから、という段階です。
なぜ「1〜5で点数をつけて」ではダメなのか
いちばん分かりやすい方法は、AIに人物像を渡して「この商品を買いたいですか?1〜5で答えて」と聞くことです。論文ではこれを「数字で直接聞く方法」として試しました。
結果は、AIはほとんど「3」と答え、「1」や「5」はほぼ出さなかったそうです。人間のアンケートは「4」や「5」が多く、もっとばらつきます。平均は近くても、答えの散らばり方がまったく違うので、調査の代わりには使えません。
ChatGPTなどに「この案、何点?」と聞いて、無難な点数ばかり返ってきた経験がある人も多いと思います。それと同じことが、論文でも数字で確かめられたわけです。
SSRのしくみ|4ステップ
そこで論文が提案したのが SSR(Semantic Similarity Rating:意味の近さで点数化する方法)です。AIに数字を言わせず、文章で答えさせてから、別の道具で点数に直します。
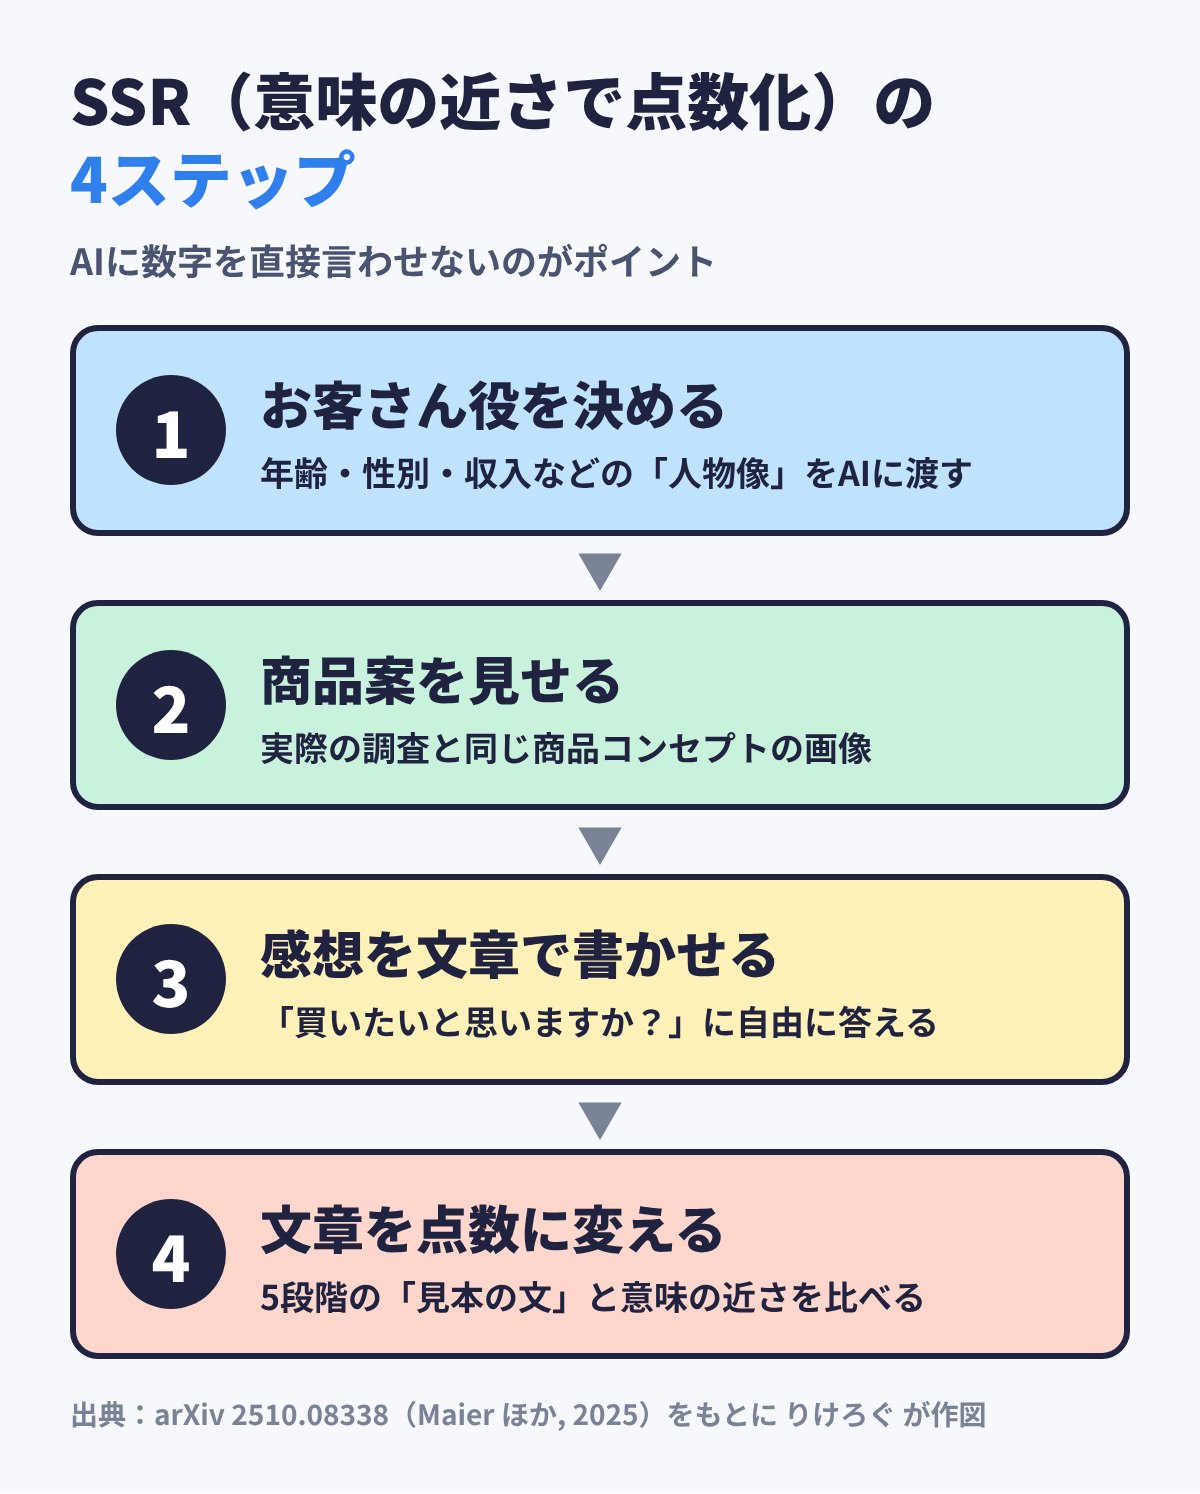
- お客さん役を決める:実際のアンケート回答者と同じ年齢・性別・地域・収入などを、AIに「あなたはこういう人です」と渡します
- 商品案を見せる:人間の調査で使ったのと同じ商品コンセプトの画像を見せます
- 感想を文章で書かせる:「買いたいと思いますか?」に自由に答えさせます
- 文章を点数に変える:「買うことはまずない」〜「ぜひ買いたい」のような5段階の見本の文と、AIの感想の「意味の近さ」を計算して点数にします
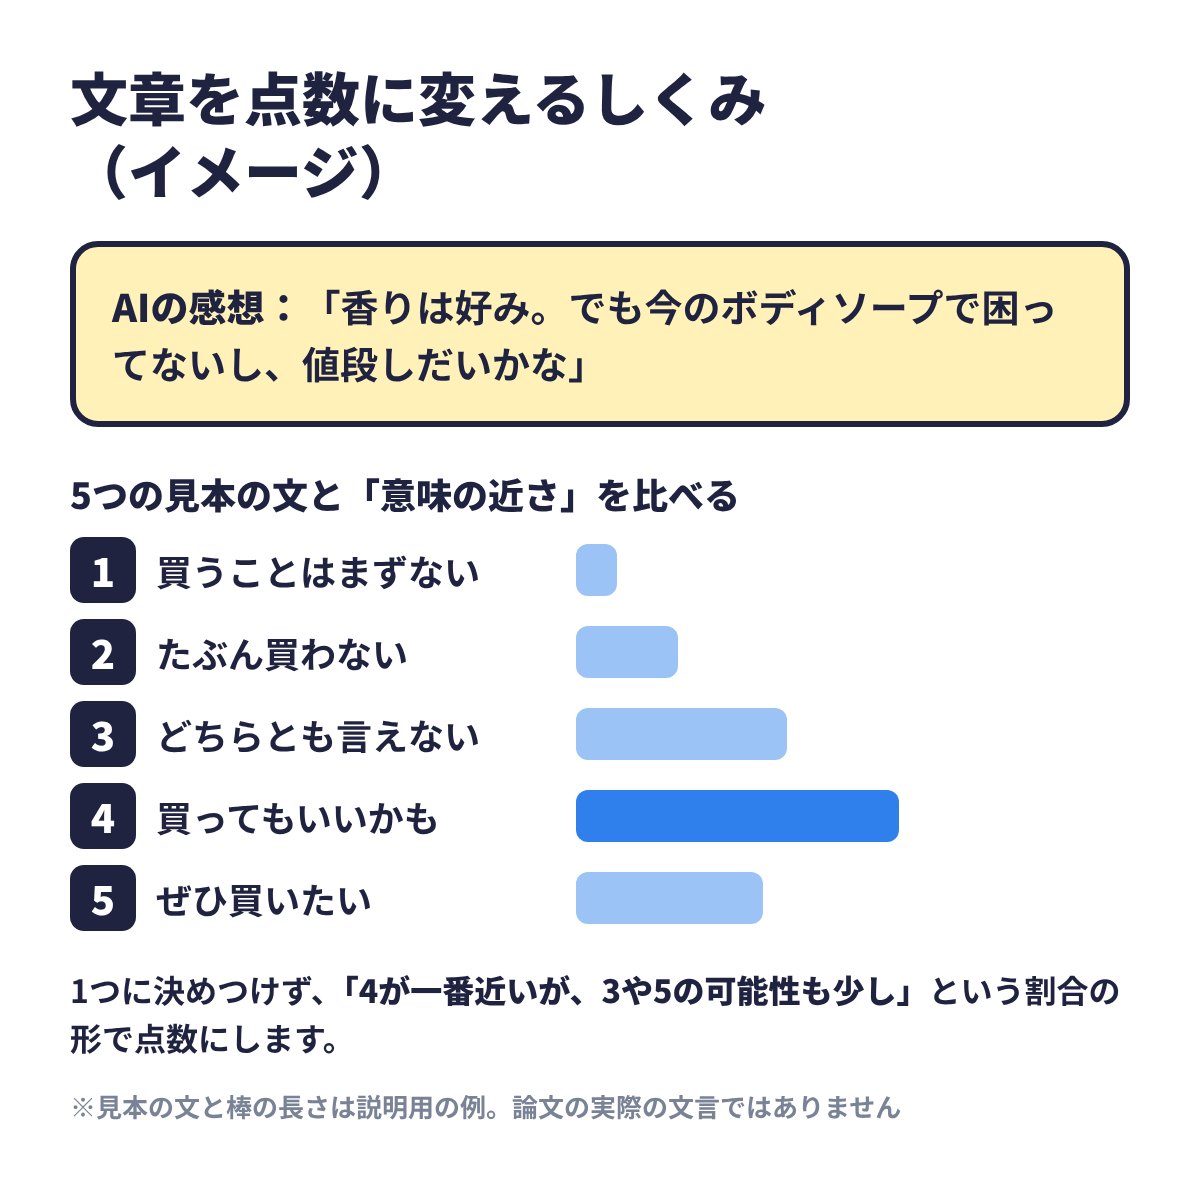
4番目の「意味の近さ」は、文章を数字の並び(埋め込み)に変えて比べる技術です。論文では OpenAI の text-embedding-3-small を使っています。見本の文は6セット用意して、結果を平均しています。
ポイントは、いちばん近い1つに決めつけず「4の可能性が高いが、3や5も少しある」という割合の形にすることです。これで、人間の回答のような自然なばらつきが出ます。
結果|どれくらい人間に近かった?
比べた相手は、米国で行われた日用品(パーソナルケア商品)のコンセプト調査57本、合計9,300人の回答です。使ったAIは GPT-4o と Gemini 2.0 Flash の2つです。
答えの散らばり方は、SSRがいちばん近い
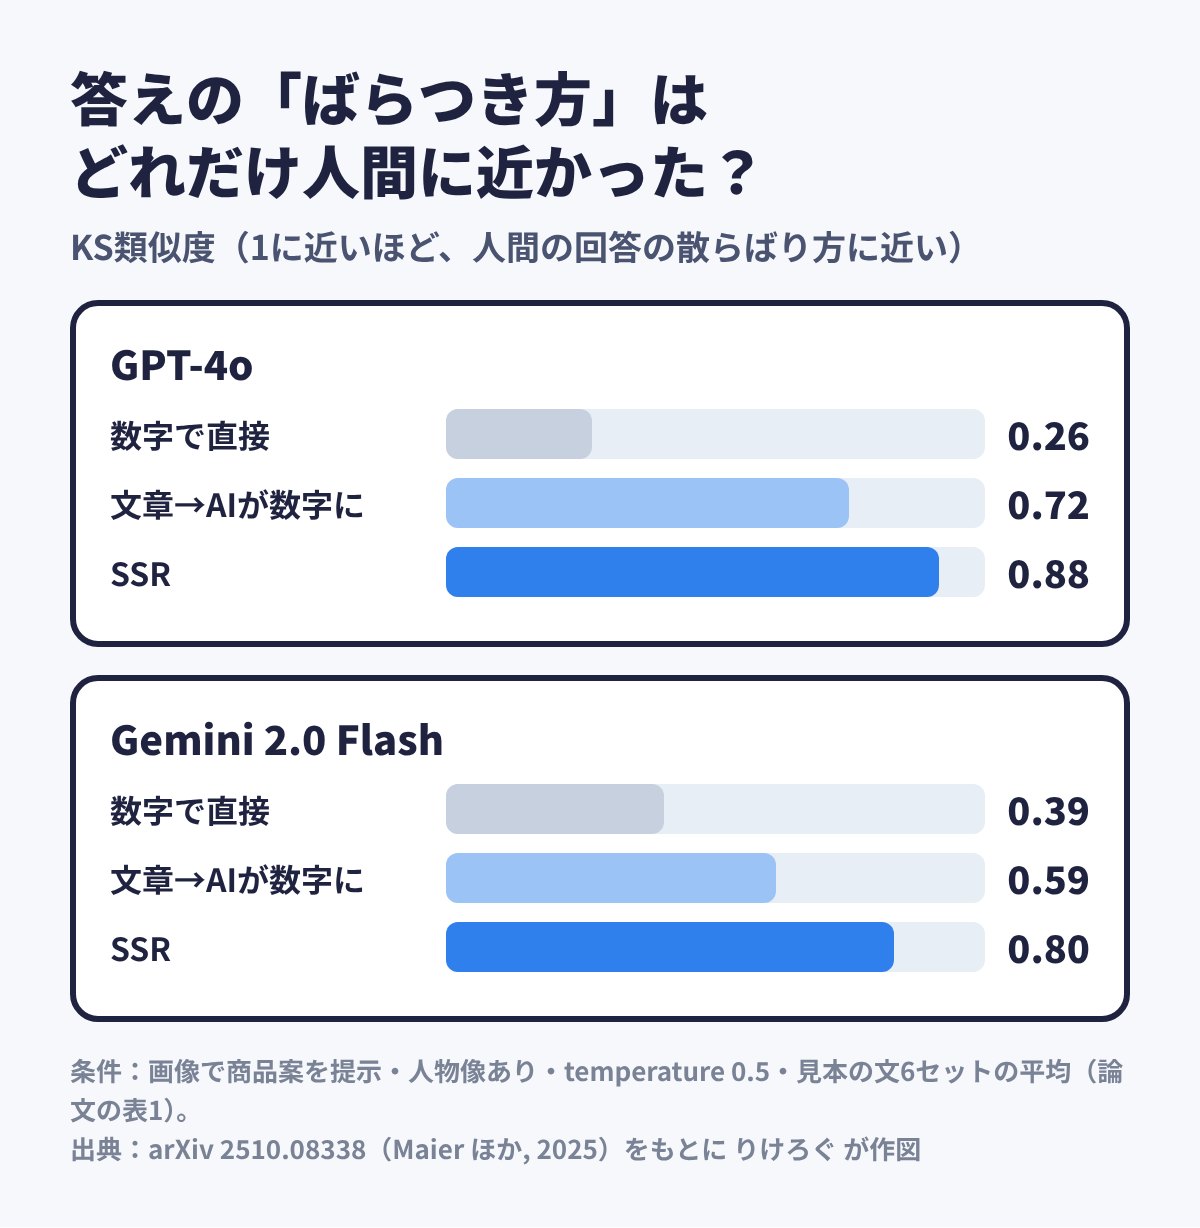
「KS類似度」は、AIの答えの散らばり方が人間とどれだけ似ているかを0〜1で表した数字です。GPT-4o では、数字で直接聞くと0.26、SSRでは0.88まで上がりました。
「人間の90%」の正しい意味
SNSでよく見る「人間の90%の信頼性」は、少し説明が必要です。論文では、人間の回答者を半分に分けたとき、2つのグループの結果がどれだけ一致するかを「人間どうしでも出せる上限」とみなしました。
そのうえで、57本の商品案の「買いたい度」の順位づけについて、AIと人間の一致度がその上限の何%に届いたかを計算しています。GPT-4o の SSR は約90%(90.2)、Gemini 2.0 Flash は約91%(90.6)でした。
つまり「人間と90%同じ答え」という意味ではありません。「どの商品案がウケるかの並び順」が、人間どうしの再現性の約9割まで届いた、という意味です。
人物像を入れないと、順位づけが崩れた
おもしろいのは、年齢や収入などの人物像を渡さなかった場合です。答えの散らばり方は似たままでしたが、商品案の順位づけの一致度は大きく下がりました(Gemini 2.0 Flash・画像の条件で約16%)。
AIは「いろいろな人になりきる」ことで、はじめて商品ごとの差を出せた、ということです。
年齢・収入は再現、性別・地域は不十分
| 属性 | 論文の結果 |
|---|---|
| 年齢 | 若い人と年配の人で低く、中間で高い山型。GPT-4oはよく再現 |
| 収入 | 「家計が苦しい」層で低い傾向を2つのAIとも再現 |
| 価格帯 | どの価格帯の商品案で低くなるかの傾向は、人間とAIで同じだった |
| 性別・地域 | 再現はあまりうまくいかなかった(人間側でも差は小さい) |
| 人種 | 一貫して再現できなかった |
論文は「人物像の設定は、すべての層の代わりとして信頼できる段階ではない」と書いています。特定の層だけを狙った調査に使うのは、まだ早いと言えます。
AIの感想は「詳しく、ほめすぎが少ない」
人間の自由回答は「いいと思う」のような短いものが多かったそうです。AIの感想は、良い点と気になる点を理由つきで書くことが多く、論文は「ほめすぎ(ポジティブ偏り)が少ない」と評価しています。
ただし、それが本当の消費者の気持ちとして正しいかどうかは検証されていません。「詳しい」と「正しい」は別の話です。
SNSの言い方と論文の違い
| SNSでの言い方 | 論文に書いてあること |
|---|---|
| 市場調査業界は終わった | 人の調査の完全な代わりではない、と論文自身が書いている |
| 人間の90%の信頼性 | 人間どうしの一致度を基準にした「相関の比」が約90% |
| 年齢・収入の反応を完璧に再現 | 「比較的よく」再現。性別・地域・人種は不十分 |
| 価格をA/Bテストできる | 価格を変える実験はしていない |
| 1,000人の面談がひと晩でできる | 論文で確かめたのは「買いたい度」と「関連性」の質問だけ |
注意点|この論文から言えないこと
- 対象が狭い:米国の日用品のコンセプト調査57本だけ。家電やサービス、日本の消費者で同じ結果になるかは分からない
- 見本の文はこの調査用に調整:論文自身が「ほかの調査でどこまで通用するかは分からない」と書いている
- AIは2つだけ:GPT-4o と Gemini 2.0 Flash。ほかのモデルは一部試して、答えが安定しないので外したと書かれている
- AIが知らない分野は苦手:学習データに情報が少ない商品では、もっともらしい意見を作れない
- 本当に買うかは別:「買いたいか」という質問の答えで、実際の購入行動ではない
わたしたちが使えるヒント
論文は企業の市場調査の話ですが、ふだんAIに意見を聞くときにも役立つ考え方があります。ここからは論文の結果をもとにしたわたしの考えで、効果を測ったものではありません。
- 点数だけを聞かない:「何点?」より「どう思うか、理由と一緒に書いて」のほうが、AIの本音(の傾向)が出やすい
- 読み手の人物像を具体的に渡す:「20代・初めて使う人」「50代・価格重視の人」など、何人分か書き分けてもらう
- 最後は本物の声で確かめる:AIの感想はたたき台。大事な判断は、実際の人の反応やデータで確かめる
たとえば、企画書やブログの題名を見てもらうときは、こんなふうに頼めます。
あなたは「スマホは使えるが、生成AIは初めての40代の会社員」です。次の題名を見て、読みたいと思うか、思わないかを、理由と一緒に3〜4文で正直に書いてください。点数はつけなくて大丈夫です。
AIの答えをどこまで信じるかは、生成AIの答えはどこまで信じていい?で詳しく書いています。
よくある質問
Q. この方法で、本当にアンケートは不要になりますか?
A. 論文は「なくなる」とは言っていません。早い段階で「どの案が良さそうか」をしぼる道具として期待できる、というのが論文の立場です。最終判断は人の調査が必要です。
Q. 個人でも試せますか?
A. 論文のコードは GitHub で公開されています。ただし、AIの API と埋め込みモデルを使うプログラムの知識が必要で、見本の文も自分の目的に合わせて作る必要があります。
Q. ChatGPTに「お客さんになりきって」と頼むのと何が違いますか?
A. なりきって感想を書かせるところまでは同じです。違いは、その文章を決まった見本の文と比べて機械的に点数に直すところと、実際の人間の調査結果と比べて精度を確かめたところです。
まとめ
- AIに数字を直接聞くと「3」ばかり。文章で答えさせて、意味の近さで点数にすると人間に近づいた
- 商品案の順位づけは、人間どうしの再現性の約9割まで届いた
- 人物像を入れることが大事。ただし性別・地域などは再現が不十分
- 対象は米国の日用品57調査だけ。「市場調査が終わった」は言いすぎ
出典:Maier, B. F. ほか「LLMs Reproduce Human Purchase Intent via Semantic Similarity Elicitation of Likert Ratings」arXiv:2510.08338(v3, 2025年10月27日)。確認日:2026年11月22日
この記事でできるようになったこと「AIが人間の代わりにアンケートに答える」話を、どこまで信じていいか判断できる
やってみる次にAIに意見を聞くとき、点数ではなく「理由つきの感想」で頼んでみる
あなたは〇〇な人です。この案を見て、良いと思う点と気になる点を、理由と一緒に正直に書いてください。点数はつけなくて大丈夫です。
次に「AIの答え、どこまで信じていい?」と思ったら
答えを確かめる間違いの確かめ方5ステップほかの疑問なら
コメント