「AIの料金表や上限の説明に『トークン』と書いてある。文字数とは違うの?日本語だと損なの?」
先に答えです。トークンは、AIが文章を読むときに区切る「かたまり」です。1文字が1トークンとは限らず、何トークンになるかは、言葉とAIのモデルによって変わります。
OpenAIが公開している数えるツールで、同じ意味の文を日本語と英語で数えてみました。
- 「今日は雨なので、家で本を読みます。」(17文字)は11トークン
- 同じ意味の英語の文(51文字)は14トークン
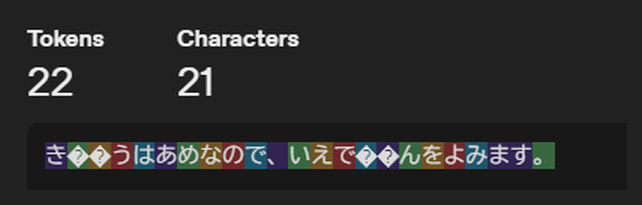
- 同じ文をひらがなだけで書くと16トークンに増えた
- 古い数え方(GPT-4のころ)では、日本語の文が17トークンになった
この1文では、新しい数え方のほうが日本語を少ないトークンで数えていました。ふだんChatGPTを定額のプランや無料版で使うだけなら、トークンを数える必要はほとんどありません。関係してくるのは、長い会話や長い資料を渡すとき、使える量の上限、APIの料金です。
この記事は、こんな人に向けて書いています
- AIの説明で「トークン」という言葉が出てきて、意味が分からない
- 「100万トークン」がどれくらいか知りたい
- 日本語は英語より不利なのか知りたい
2026年11月9日に、OpenAIの公式の数えるツール(Tokenizer)で試しました。ログインせずに使えます。
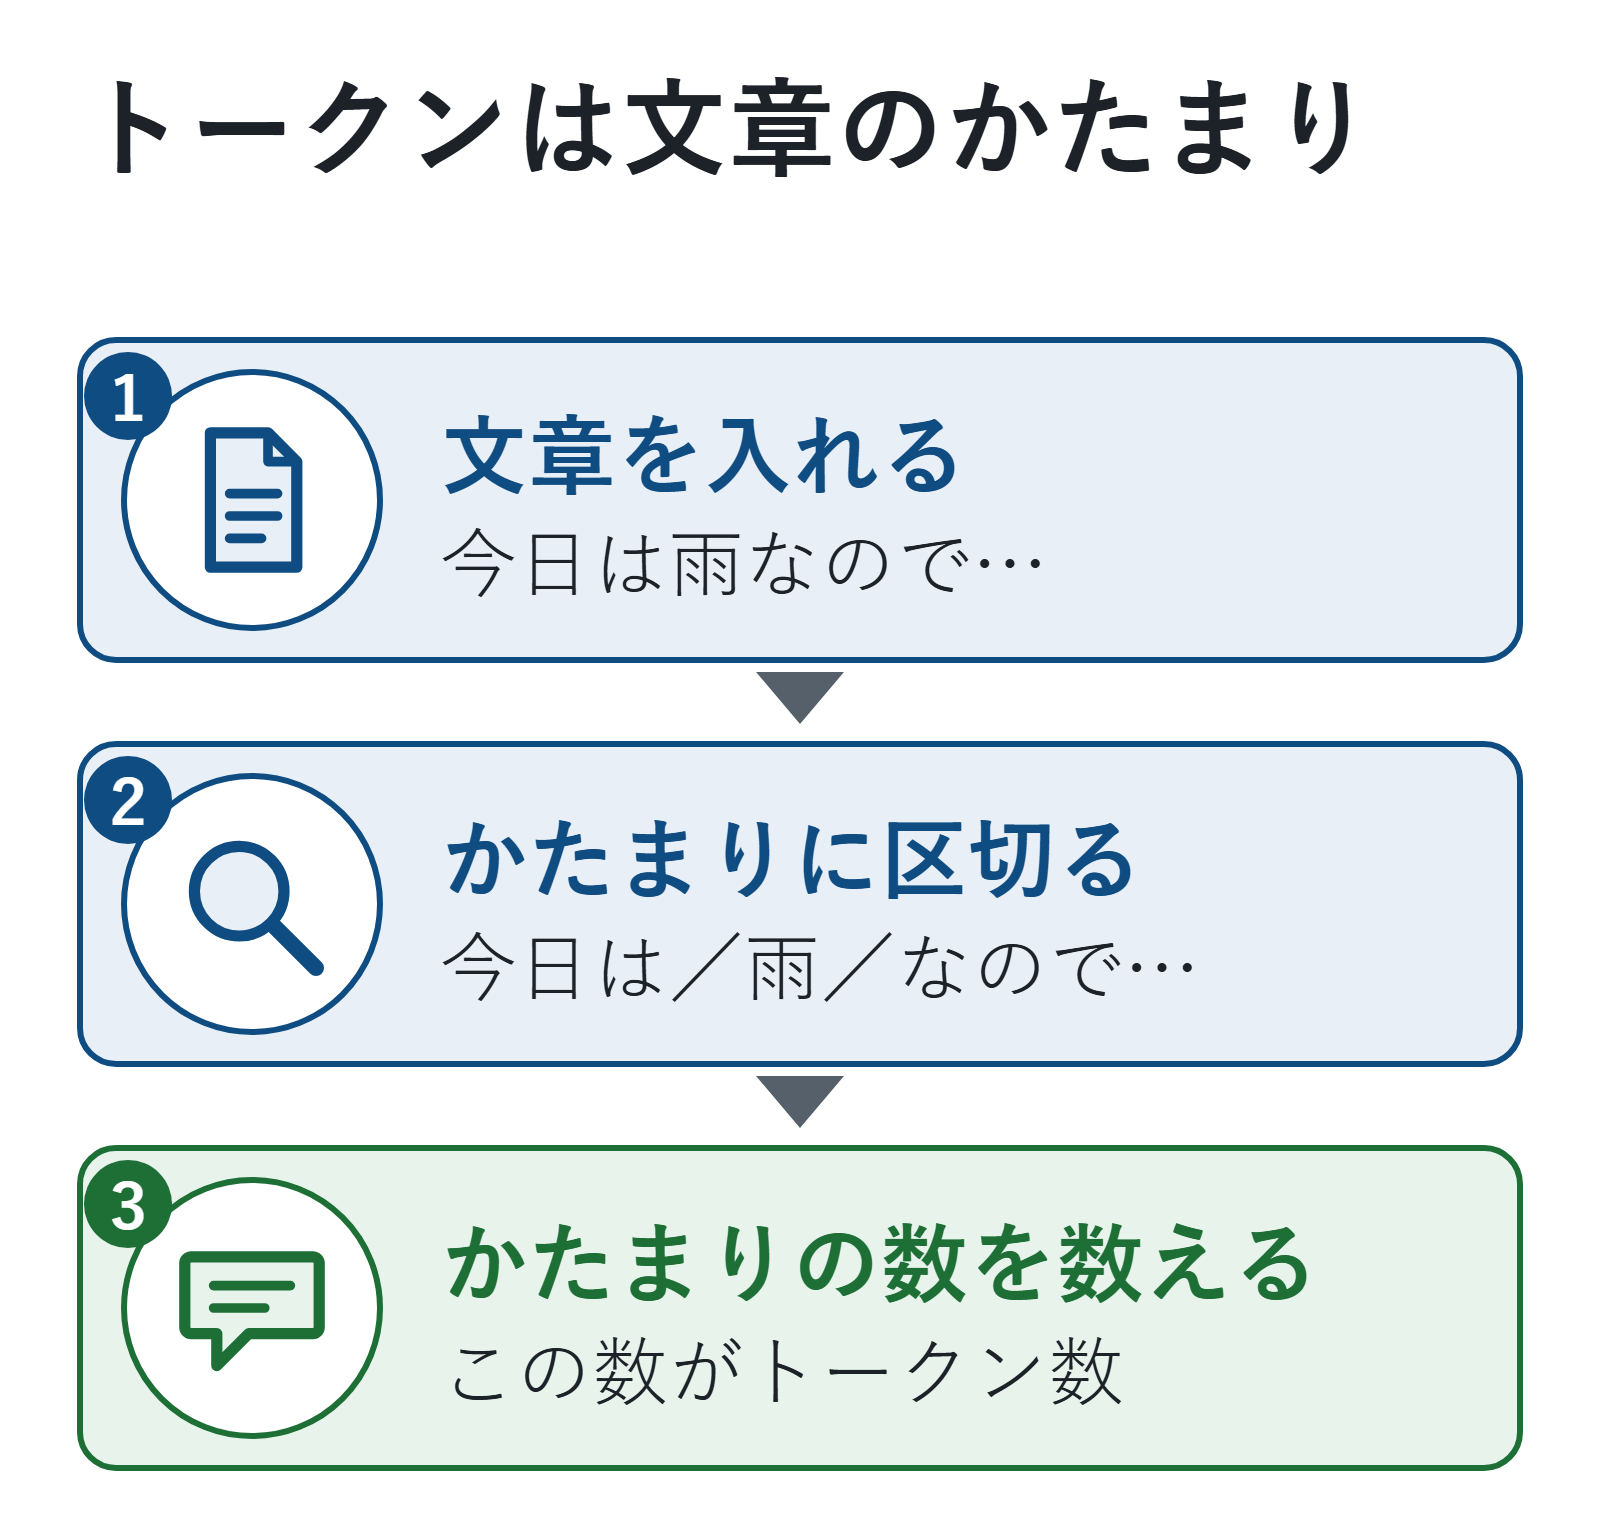
トークンは、AIが文章を区切る「かたまり」
AIは、文章を1文字ずつではなく、よく出てくる文字の並びごとに区切って扱います。この区切ったかたまりがトークンです。
OpenAIの公式ヘルプでは、トークンは「1文字のことも、単語の一部や単語全体のことも、句読点のこともある」と説明されています。同じ文でも、モデルや言葉によってトークンの数が変わる、とも書かれています。
数えるツールに文を入れると、区切られたかたまりが色分けされて表示されます。
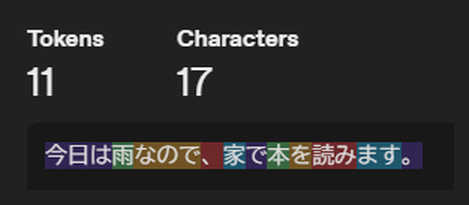
「今日は」「なので」のように、よく使う言葉は1つのかたまりになっていました。「読みます」は「読み」と「ます」の2つでした。17文字で11トークンです。
日本語と英語で、同じ意味の文を数えた
同じ意味の英語の文も入れてみました。
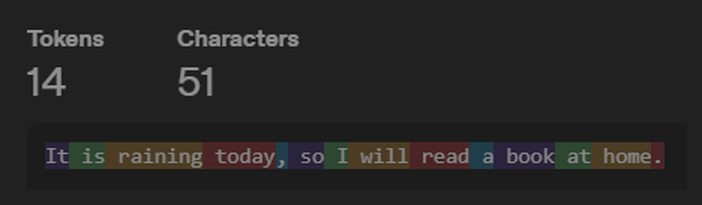
英語は51文字で14トークンでした。英語は、ほぼ1つの単語が1トークンです。
ツールでは、古い数え方(GPT-4とGPT-3.5のころ)にも切り替えられます。3つの文を、新しい数え方と古い数え方の両方で数えた結果です。
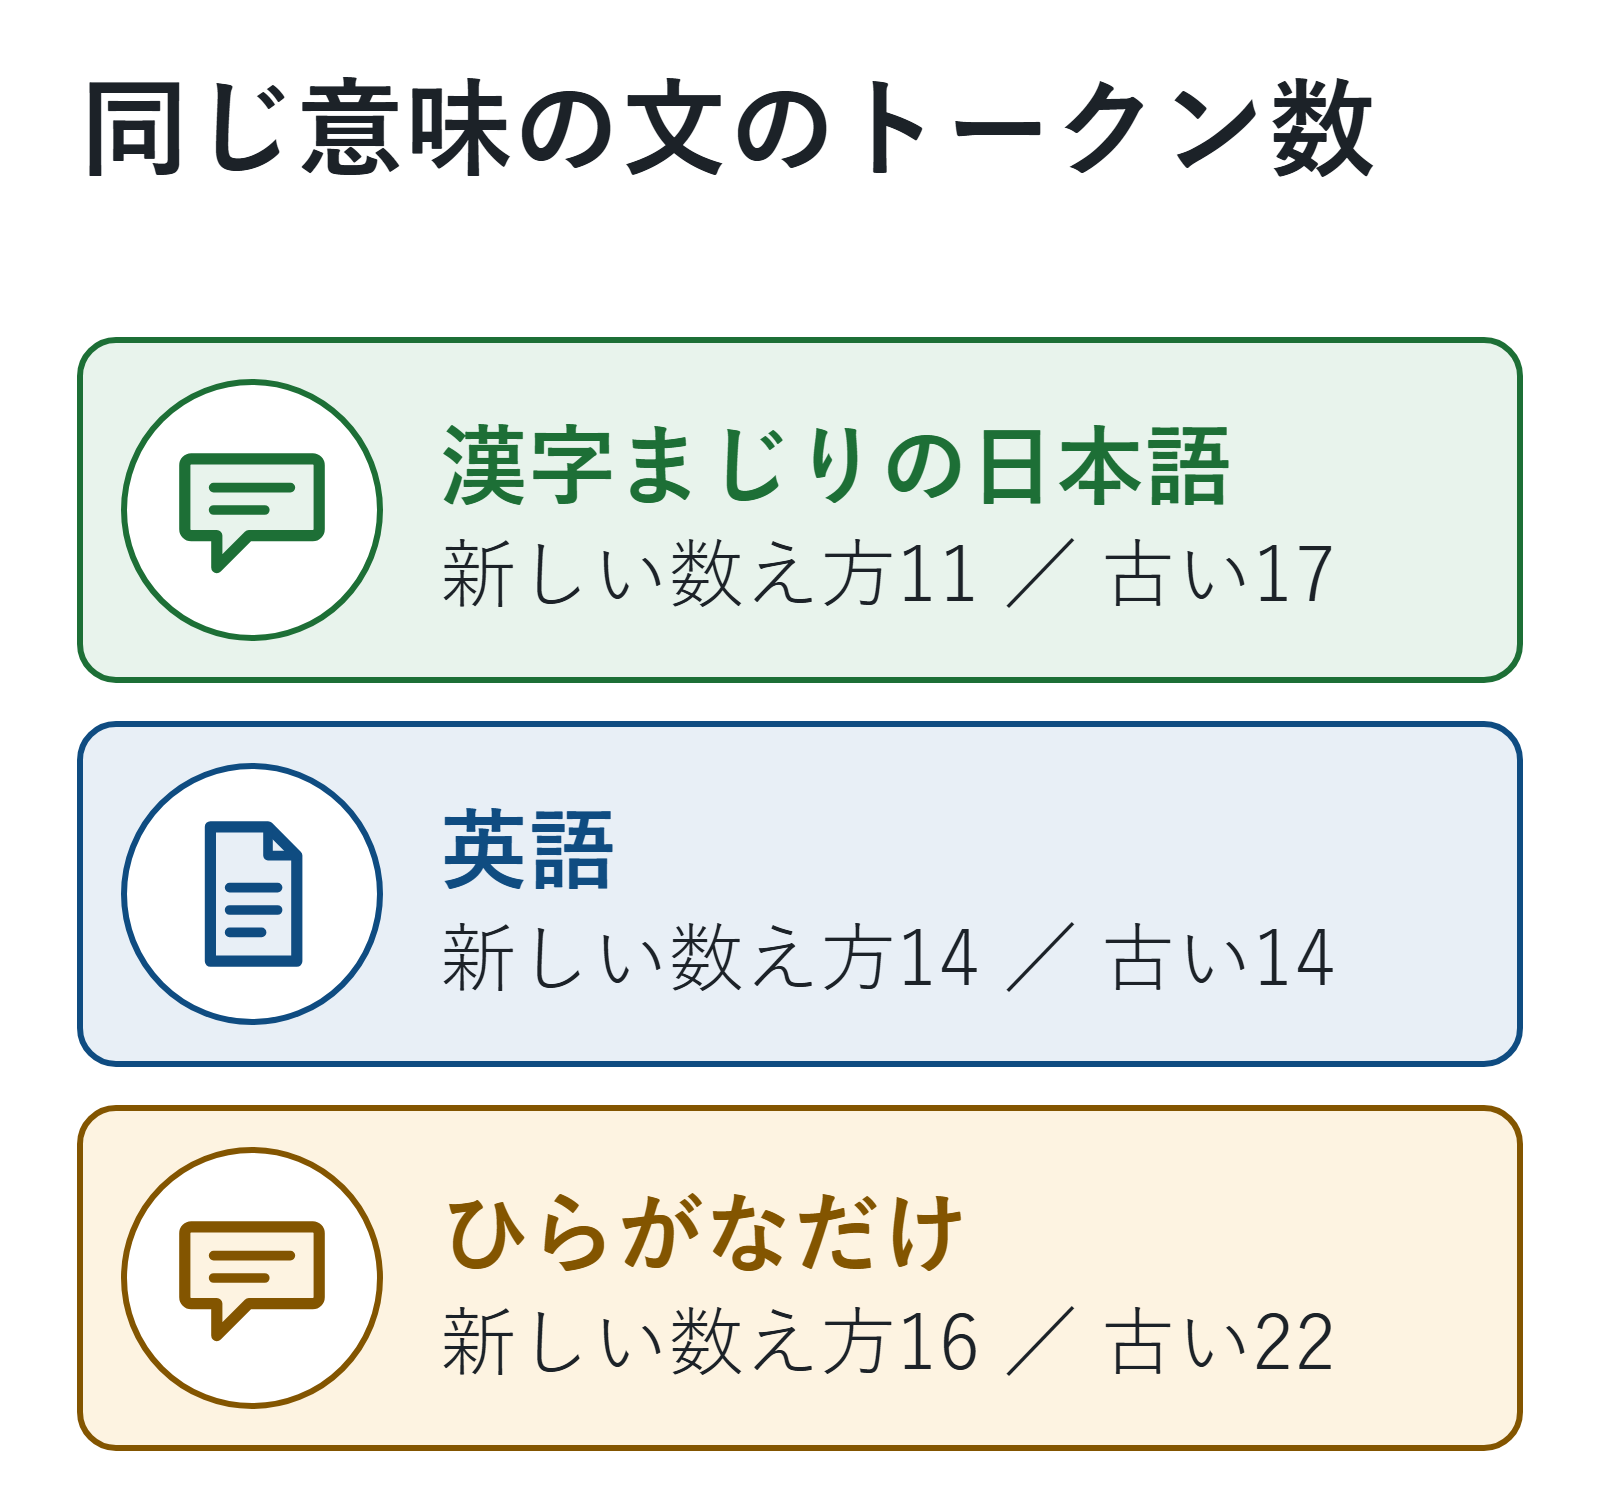
- 新しい数え方では、日本語(11)のほうが英語(14)より少なかった
- 古い数え方では、日本語が17に増え、英語(14)より多かった
- ひらがなだけで書くと、どちらの数え方でも増えた
古い数え方では、ひらがなの「ょ」や「ほ」が、1文字で2つのトークンに分かれていました。
「日本語は英語より多くのトークンを使う」という説明をよく見かけます。古い数え方では、今回の文でもそうでした。いまの数え方では、少なくともこの1文では逆になりました。
試したのは短い文1つずつで、ChatGPTのモデルの数え方だけです。ClaudeやGeminiは、このツールでは数えられないので試していません。
100万トークンはどれくらい?
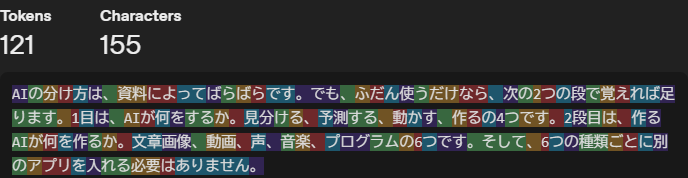
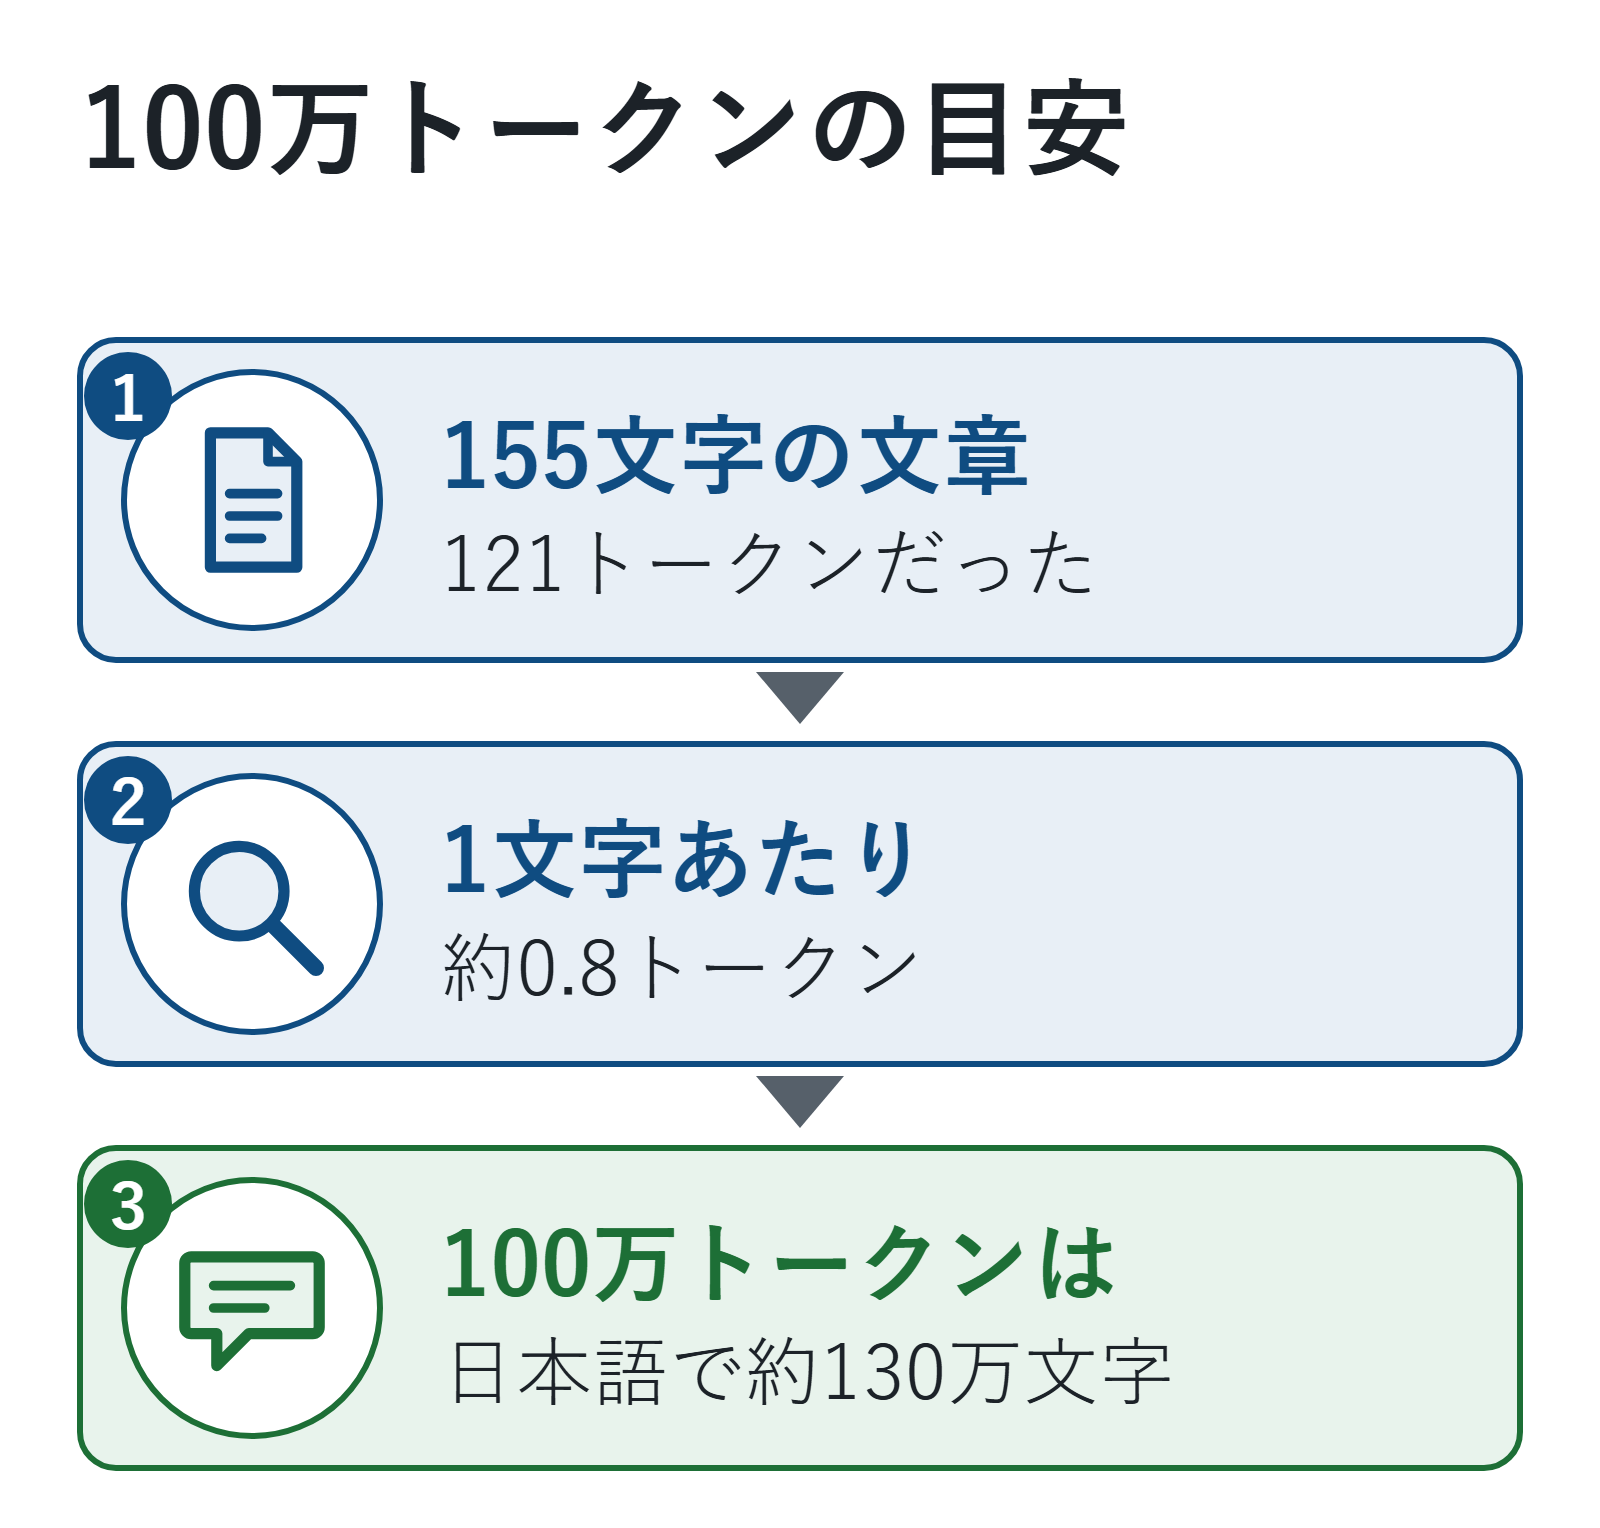
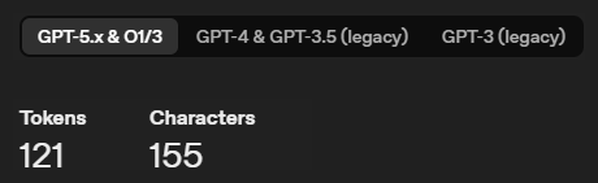
自分で書いた155文字の文章を数えると、新しい数え方で121トークンでした。1文字あたり約0.8トークンです。
この割合で計算すると、100万トークンは日本語で約130万文字になります。ただし、文章の中身やモデルで変わるので、目安です。
モデルを変えると、同じ文章でも数が変わります。Anthropicの公式ドキュメントには、Claudeの新しいモデルは古いモデルより、同じ文章で約30%多くトークンを数えると書かれています。
ふだんの使い方で、トークンが関係する3つ
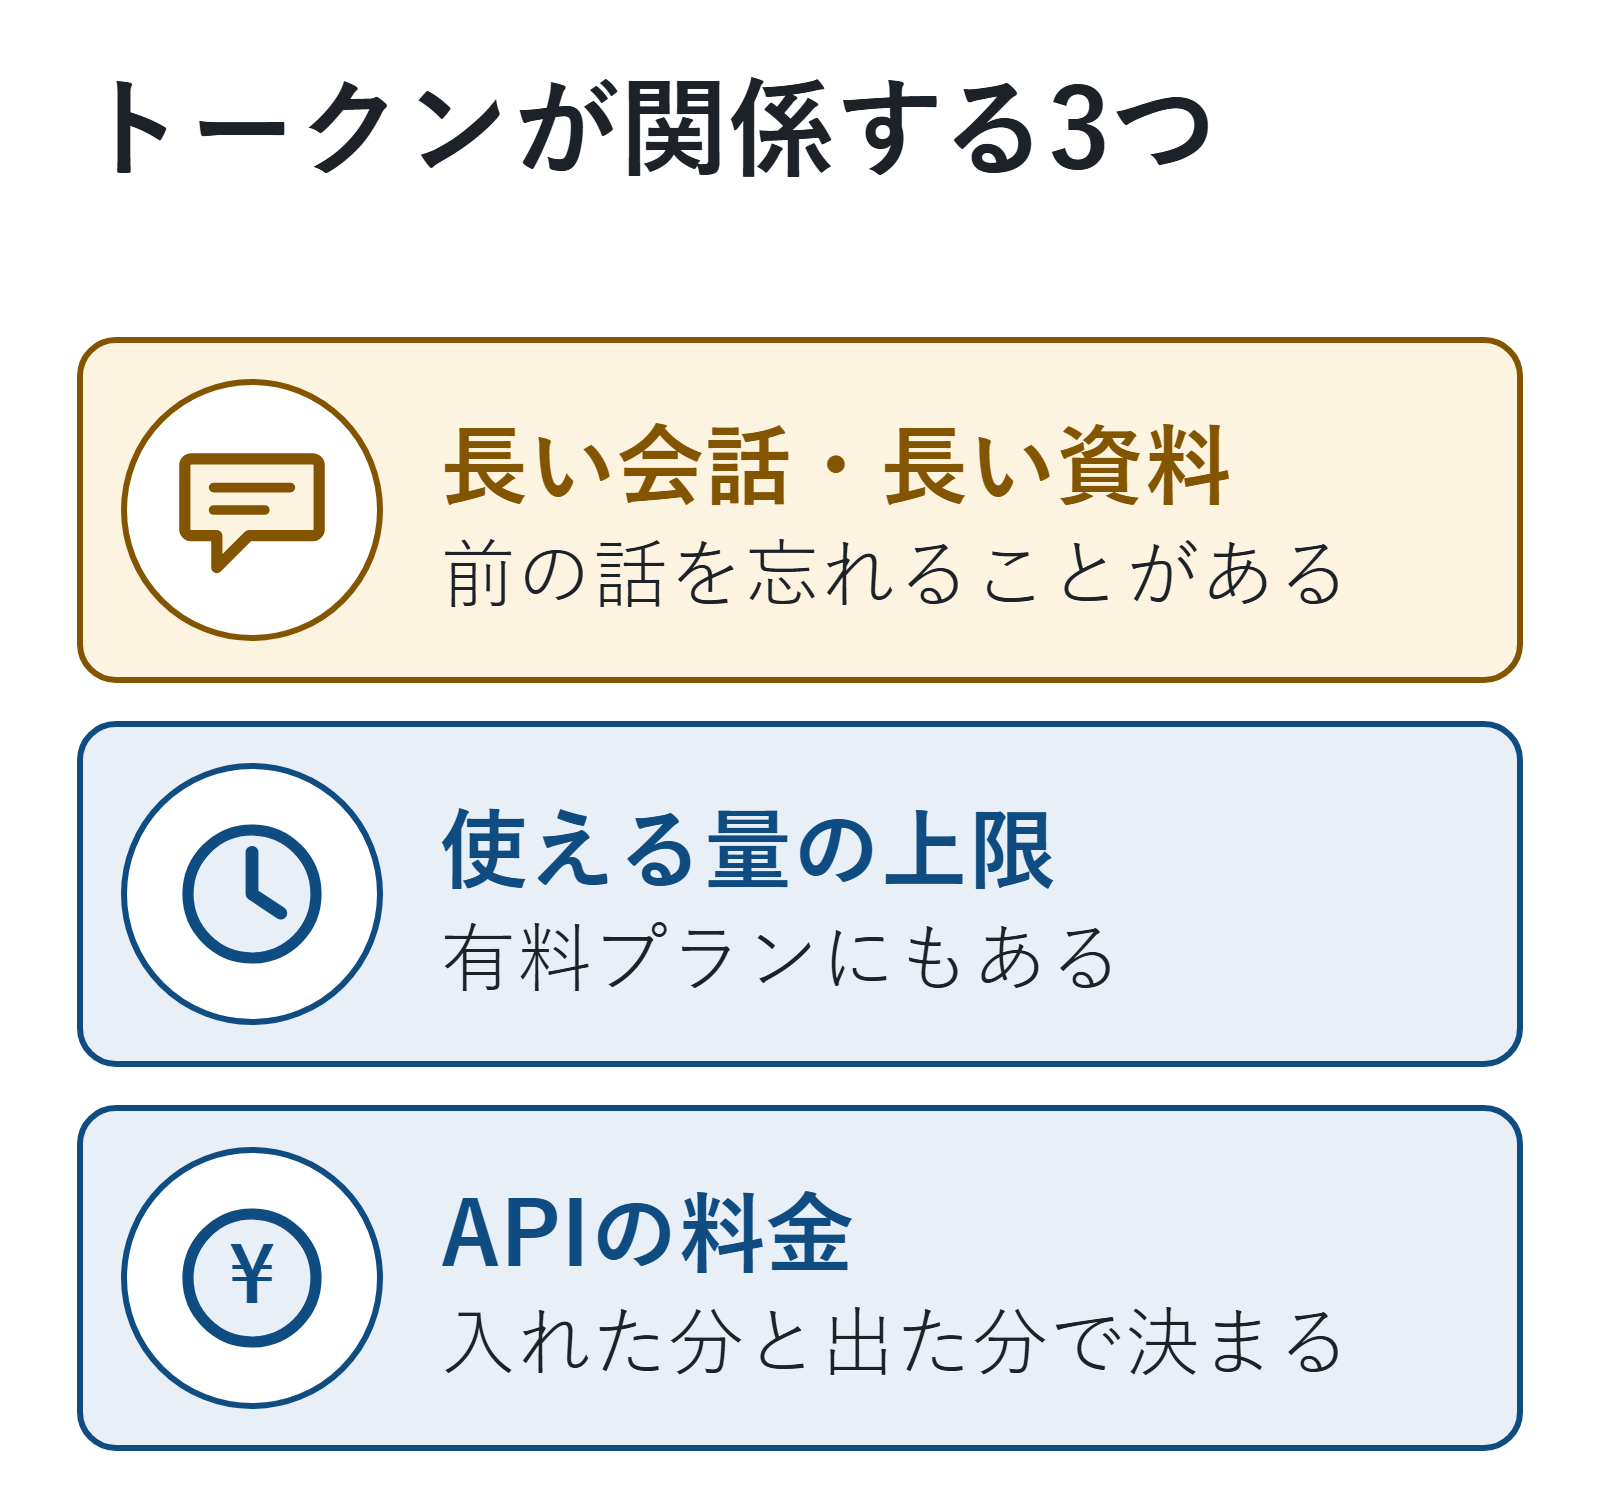
長い会話や資料で、前の話を忘れる
AIが一度に読める量には、トークンの数で上限があります。長い会話を続けたり、長い資料を渡したりすると、最初のほうの内容を忘れることがあります。
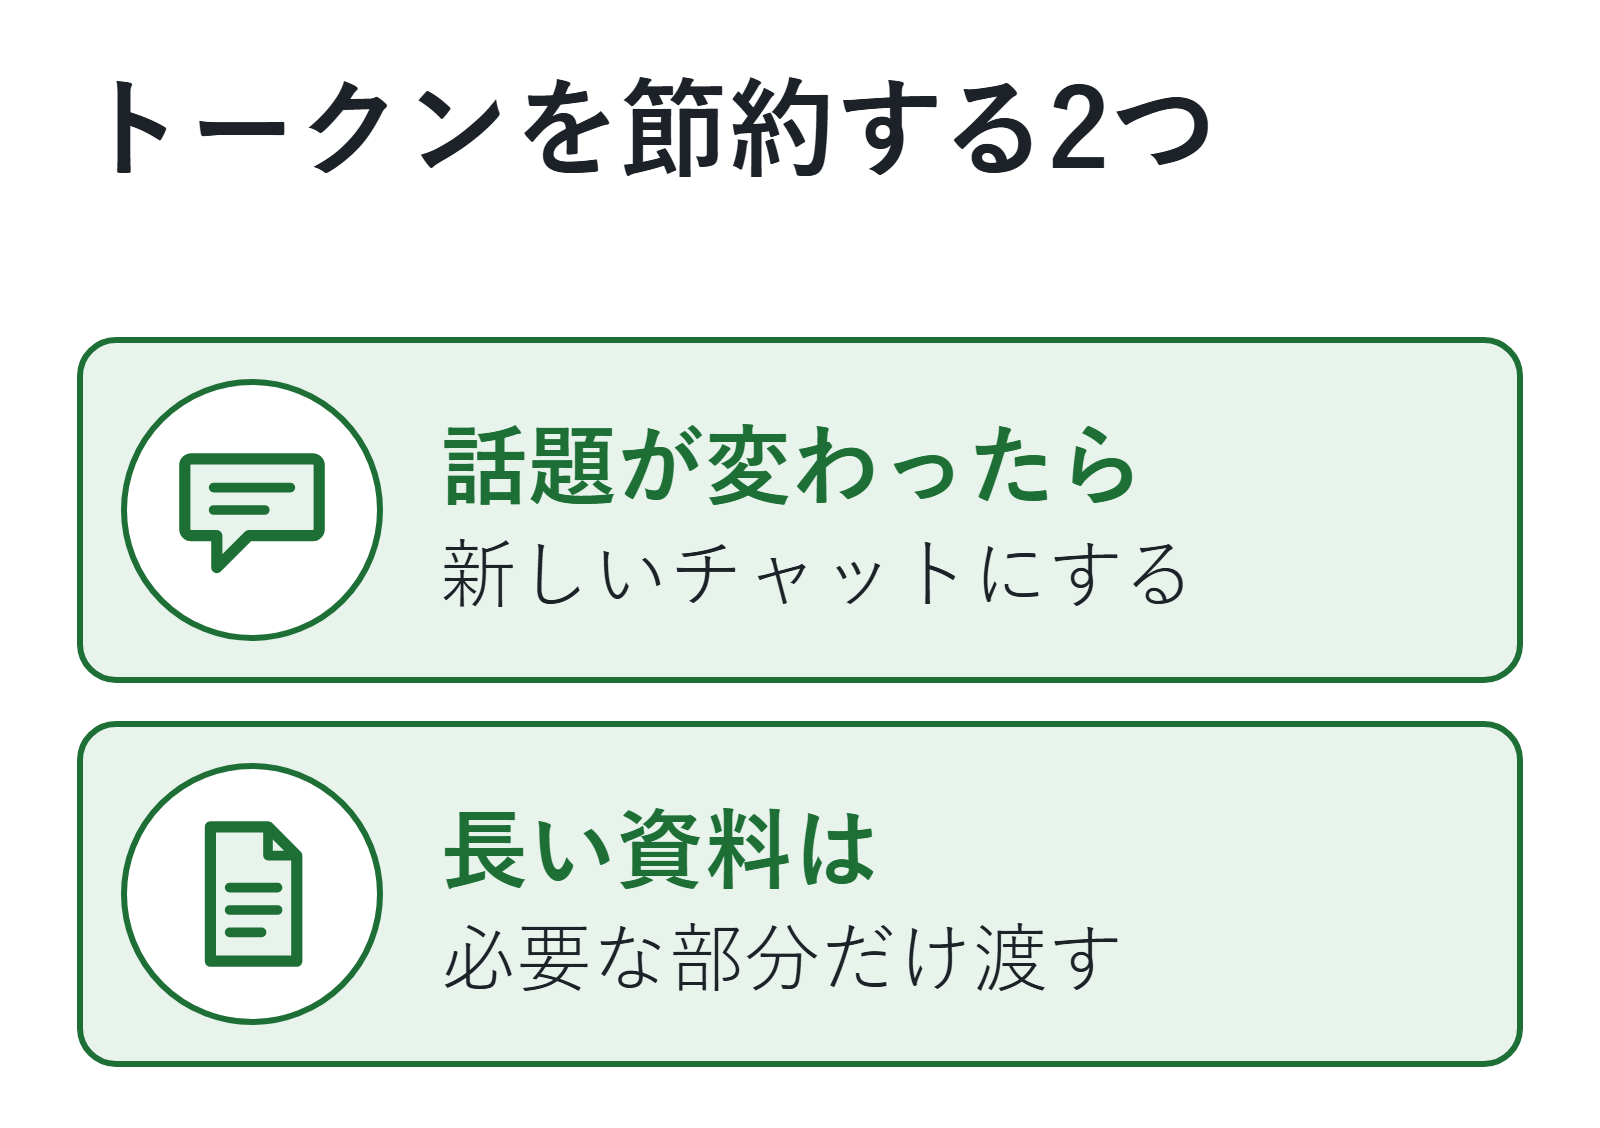
対処は、新しいチャットに要点を引き継ぐことです(ChatGPTが前の話を忘れるときの引き継ぎ方)。長い資料をどこまで読めるかは、長い資料を読ませるならどのAI?で、4つのAIに6万字を渡して比べています。
使える量の上限
有料のプランでも、使える量に上限があります。Claude Codeのように、たくさんのファイルを読む道具では、上限に届きやすくなります(Claude Codeが上限に達したときの対処)。
APIの料金
アプリに組み込むAPIでは、入れたトークンと出てきたトークンの数で料金が決まります。OpenAIのヘルプでは、考えるモデルが内部で使うトークンも、出てきたトークンとして数えると説明されています。答えが短くても、見えているより多くのトークンを使うことがあります。
ChatGPTやClaudeのアプリを定額のプランや無料版で使う場合は、APIのように、トークンの数で毎回の料金が決まるしくみではありません。
文字数を指定しても、ぴったりにならない理由
AIはトークンのかたまりで文章を作るので、1文字ずつ数えながら書いているわけではありません。「300字で」と頼んでも、文字数がずれるのはこのためです。
実際に3つのAIに頼んで数えた結果と、近づける頼み方は「ChatGPTが指定した文字数を守らないのはなぜ?」にまとめています。
自分で数えてみる手順
- OpenAIのTokenizerを開く(ログインは要りません)
- 上のタブで数え方を選ぶ(いまのモデルなら左の「GPT-5.x & O1/3」)
- 入力欄に文を貼る
- 下の「Tokens」がトークンの数、「Characters」が文字数
貼った文は、OpenAIのサイトに送られます。個人情報や仕事の文書は入れずに、試す用の文で数えてください。
よくある質問
- トークンを日本語で言うと?
-
決まった訳はありません。「言葉のかたまり」「文章を区切った単位」と考えると分かりやすいです。
- 1トークンは何文字くらい?
-
英語では、OpenAIのヘルプに「1トークンは約4文字」とあります。日本語は今回の文章で、1文字が約0.8トークンでした。文章やモデルで変わるので、目安として使ってください。
- トークンを節約するには?
-
話題が変わったら新しいチャットにする、長い資料は必要な部分だけを渡す、の2つが手軽です。ローカルのAIで一度に読める量(コンテキスト長)を変えた実験は「ローカルLLMのコンテキスト長とは?」に書いています。
まとめ
- トークンは、AIが文章を区切るかたまり。文字数とは違う
- 同じ意味の文で、新しい数え方は日本語11・英語14、古い数え方は日本語17・英語14だった
- 100万トークンは、今回の割合で日本語約130万文字(目安)
- ふだん定額で使うだけなら数えなくていい。関係するのは、長い会話・上限・APIの料金
次に読む記事
この記事でできるようになったことトークンが文字数と違うことと、長い会話・上限・料金にどう関係するかが分かる
やってみるOpenAIのTokenizerに、試す用の短い文を入れて数えてみる
次に「指定した文字数にならないのはなぜ?」と思ったら
ChatGPTが指定した文字数を守らないのはなぜ?300字に近づける頼み方頼んだ文字数にならないという人にほかの疑問なら
- ChatGPTが前の話を忘れるときは?新しいチャットに引き継ぐ頼み方長い会話で前の話を忘れられたという人に
- AIの種類を図でわかりやすく|生成AIで作れる6つと、やりたいこと別の選び方AIの全体像を知りたいという人に
難しかった・違う悩みだった人は、START HERE の「困ったときは」から選べます。
参考
- OpenAI Help「Understanding and counting tokens」(2026年11月9日に確認)
- OpenAI「Tokenizer」(2026年11月9日に使用)
- Anthropic「Token counting」(2026年11月9日に確認)